






在sql中处理因字符集冲突导致的join报错,核心做法是在连接条件中对参与连接的列显式使用`collate`子句指定兼容的排序规则,或者在表定义阶段统一字符集与排序规则。通过强制对齐两边的排序规则,可以消除数据库引擎在比较字符串时的隐式转换警告或错误,确保查询正常执行。
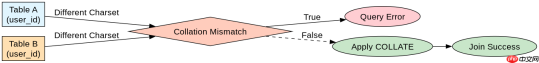
如何识别具体的字符集不匹配
当执行包含`JOIN`操作的查询时,如果两张表的关联字段虽然数据类型相同(例如都是`VARCHAR`),但定义的字符集(如`utf8mb4`与`latin1`)或排序规则(如`utf8mb4_general_ci`与`utf8mb4_unicode_ci`)不一致,数据库通常会抛出类似"Illegal mix of collations"的错误。要识别这个问题,需要检查两张表中用于连接的字段的实际元数据属性。
SELECT
    TABLE_NAME,
    COLUMN_NAME,
    CHARACTER_SET_NAME,
    COLLATION_NAME
FROM
    INFORMATION_SCHEMA.COLUMNS
WHERE
    TABLE_NAME IN ('users', 'orders')
    AND COLUMN_NAME = 'user_id';
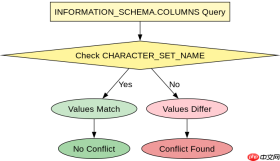
上述查询会返回两张表中`user_id`字段的详细字符集信息。如果返回结果中`CHARACTER_SET_NAME`或`COLLATION_NAME`不同,即证实了冲突存在。例如,一张表可能使用`utf8mb4`配合`utf8mb4_0900_ai_ci`,而另一张表使用`utf8`配合`utf8_general_ci`。这种差异会导致数据库在进行等值比较时无法直接进行字节级对比,从而引发错误。
如何在JOIN语句中临时解决冲突
在不修改表结构的前提下,最直接的解决方法是在`ON`子句中为其中一个字段添加`COLLATE`关键字,强制其使用与另一个字段相同的排序规则。这种方法适用于临时修复或脚本编写,无需停机维护表结构。

SELECT
    u.name,
    o.order_date
FROM
    users u
JOIN
    orders o ON u.user_id = o.user_id
    COLLATE utf8mb4_unicode_ci;
在上面的代码中,假设`users`表的`user_id`是默认的`utf8mb4_unicode_ci`,而`orders`表的`user_id`是`utf8mb4_general_ci`。通过在`o.user_id`后追加`COLLATE utf8mb4_unicode_ci`,我们告诉数据库在比较这两个字段时,暂时将`orders`表的字段视为`utf8mb4_unicode_ci`。这样两边排序规则一致,JOIN操作即可顺利执行。需要注意的是,这种写法仅对当前查询有效,不会影响底层数据存储。
基于程序中某个输入、条件或结果的具体问题
如果在应用程序中动态构建SQL查询,且传入的参数值包含特殊字符(如Emoji或生僻汉字),在字符集未完全统一的环境中,即使使用了`COLLATE`,仍可能因为参数绑定类型的推断问题导致隐式转换失败。此时,应确保程序层面对字符串参数明确指定编码,或在数据库连接字符串中强制设置默认字符集。


