






在sql中,可以使用自连接配合聚合函数来计算排名。具体做法是将表与自身进行左连接,统计比当前记录值更大(或更小)的记录数量,然后加1得到排名。这种方法适用于不支持窗口函数的旧版本数据库,或者需要自定义复杂排名逻辑的场景。

如何使用自连接计算升序排名
通过自连接统计比当前行小的行数并加1,可以实现升序排名。假设有一张名为 employees 的表,包含 name 和 salary 字段。我们需要为每个员工按薪资升序排名。
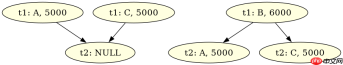
SELECT t1.name, t1.salary, COUNT(t2.id) + 1 AS rank
FROM employees t1
LEFT JOIN employees t2 ON t1.salary > t2.salary
GROUP BY t1.id, t1.name, t1.salary
ORDER BY rank;
这段代码的逻辑是:对于 t1 中的每一行,找出所有 t2 中薪资严格小于它的记录。如果没有任何记录比它小,计数为0,排名为1。如果有N条记录比它小,排名就是N+1。这种写法会产生“密集排名”(Dense Rank),即相同薪资的员工获得相同的排名,且下一个排名连续。
如何处理并列排名的情况
如果需要实现标准排名(Standard Rank,即相同排名后跳过后续名次),可以在自连接条件中加入唯一标识符。例如,使用 id 作为辅助排序键。当薪资相同时,比较 id 来决定大小关系,从而打破平局。

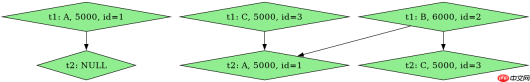
SELECT t1.name, t1.salary, COUNT(t2.id) + 1 AS rank
FROM employees t1
LEFT JOIN employees t2 ON (t1.salary > t2.salary) OR (t1.salary = t2.salary AND t1.id > t2.id)
GROUP BY t1.id, t1.name, t1.salary
ORDER BY rank;
在这个查询中,连接条件变为:如果 t1 的薪资大于 t2,或者薪资相等但 t1 的ID大于 t2 的ID,则计入计数。这样,即使薪资相同,ID较大的记录也会被认为“更大”,从而获得更高的排名数值(即更差的排名)。这实现了类似 RANK() 函数的效果,相同名次的记录会占用多个位置,导致下一个名次跳跃。
基于特定输入条件的排名结果验证
为了验证上述逻辑,我们构造一个具体的输入数据。假设 employees 表中有三条记录:(A, 5000), (B, 6000), (C, 5000)。使用第一个查询(密集排名)时,A和C的薪资都是5000,它们都比B小吗?不,它们比彼此小吗?不。它们之间没有严格的小于关系。因此,A和C各自计数的比它们小的记录数为0,排名均为1。B的薪资6000大于A和C,所以B的计数为2,排名为3。结果是:A:1, C:1, B:3。如果使用第二个查询(标准排名),加入ID比较。假设A的ID=1, C的ID=3。对于A,比它小的记录:无。排名1。对于C,比它小的记录:A(因为5000=5000且3>1)。计数1,排名2。对于B,比它小的记录:A和C。计数2,排名3。结果是:A:1, C:2, B:3。这展示了如何通过调整连接条件来控制排名的连续性。


