






解决group by后产生大量小文件倾斜的核心做法是开启map端聚合(local aggregation)并调整reducer数量,同时针对数据倾斜场景启用动态分区裁剪或自适应查询优化。通过设置hive.map.aggr为true,可以在map阶段提前合并相同key的数据,显著减少shuffle阶段传输的数据量和最终生成的文件数。若倾斜严重,需结合hive.optimize.reducededuplication.min.reducer等参数动态调整reducer个数,避免过多小文件输出。

如何配置Map端聚合以减少Shuffle数据量
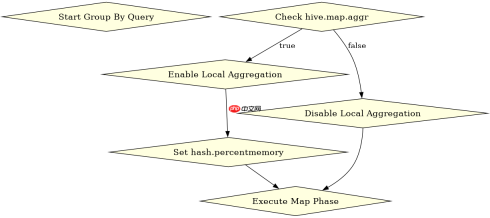
开启Map端聚合可以有效缓解因Group By产生的大量小文件问题。主要涉及两个关键参数:hive.map.aggr和hive.map.aggr.hash.percentmemory。前者控制是否启用Map端聚合,后者控制哈希表占用的内存比例。当设置为true时,Hive会在Map任务中先对数据进行局部聚合,再发送给Reduce,从而减少网络传输和最终输出的文件碎片。
SET hive.map.aggr=true;
SET hive.map.aggr.hash.percentmemory=0.5;
SELECT category, COUNT(*)
FROM sales_data
GROUP BY category;
上述配置确保在Map阶段进行局部计数,减少Shuffle数据量。预期结果是每个Map输出更少的键值对,Reduce端接收的数据更紧凑,最终输出文件数量减少。
如何通过动态调整Reducer数量优化输出文件分布
当Group By导致数据倾斜时,固定数量的Reducer可能无法均匀分配负载,产生大量小文件或少数大文件。可通过设置hive.exec.reducers.bytes.per.reducer和hive.exec.reducers.max来动态控制Reducer数量。Hive会根据输入数据大小自动计算合适的Reducer数,避免过小或过大的并行度。

SET hive.exec.reducers.bytes.per.reducer=256000000; -- 256MB per reducer
SET hive.exec.reducers.max=1000;
SELECT category, SUM(amount)
FROM sales_data
GROUP BY category;
该配置使Hive根据数据总量自动选择Reducer数量,平衡负载。预期结果是输出文件数量适中,文件大小均匀,避免小文件倾斜。
当某Key数据量极大时如何进一步处理倾斜
若某个Group By Key(如category='unknown')数据量极大,即使开启Map端聚合和调整Reducer数仍会产生倾斜。此时可采用两阶段聚合:先将倾斜Key分离出来单独处理,再与非倾斜Key结果合并。例如,使用CASE WHEN将异常Key标记,分别聚合后再UNION ALL。
WITH split_data AS (
  SELECT CASE WHEN category = 'unknown' THEN 'other' ELSE category END as cat,
         amount FROM sales_data
)
SELECT cat, SUM(amount) FROM split_data GROUP BY cat;
此方法将极端倾斜Key隔离,避免其拖慢整体任务。预期结果是任务执行时间缩短,输出文件分布更均衡,无单一超大文件。


