怎样在Spark SQL中避免RANK全表排序的性能瓶颈

胖丽君_4763

胖丽君_4763

2026-11-18

892人浏览

原创

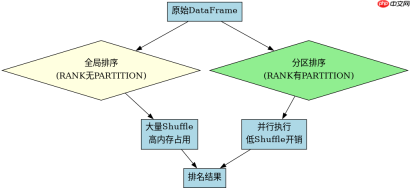
在spark sql中避免rank全表排序性能瓶颈的核心做法是:使用支持分区排序的窗口函数(如`row_number()`配合`partition by`)或采用基于哈希分区的聚合替代方案,将全局排序拆解为局部排序。具体而言,若业务逻辑允许按某个键分组后取每组top n,应显式指定`partition by key`,使spark利用shuffle进行并行处理而非单节点全量排序;若需严格全局排名且数据量极大,可考虑预采样估算分位数或使用近似算法。此方法能显著降低内存压力与shuffle开销,提升执行效率。
怎样在Spark SQL中避免RANK全表排序的性能瓶颈

如何正确使用PARTITION BY优化窗口函数

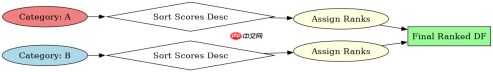
当使用`RANK()`或`DENSE_RANK()`时,若未指定`PARTITION BY`,Spark会执行全局排序,导致严重的Shuffle和内存溢出风险。正确做法是明确指定分区列,例如`RANK() OVER (PARTITION BY category ORDER BY score DESC)`,这样每个分区独立排序,可利用多Executor并行计算。
怎样在Spark SQL中避免RANK全表排序的性能瓶颈

import org.apache.spark.sql.SparkSession
import org.apache.spark.sql.expressions.Window

val spark = SparkSession.builder.appName("OptimizedRank").getOrCreate()
import spark.implicits._

// 示例数据:用户ID、类别、分数
val df = Seq(
  (1, "A", 90),
  (2, "A", 85),
  (3, "B", 95),
  (4, "B", 92),
  (5, "A", 90)
).toDF("user_id", "category", "score")

// 错误写法:全局排序,性能差
val wrongResult = df.withColumn("rank", rank().over(Window.orderBy($"score".desc)))

// 正确写法:按类别分区,局部排序
val windowSpec = Window.partitionBy($"category").orderBy($"score".desc)
val correctResult = df.withColumn("rank", rank().over(windowSpec))

correctResult.show()

何时应改用ROW_NUMBER替代RANK

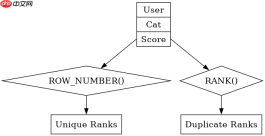
若业务只需唯一排名(无并列),应使用`ROW_NUMBER()`而非`RANK()`。因为`RANK()`需处理并列情况,可能触发额外排序逻辑,而`ROW_NUMBER()`保证唯一值,排序更高效。尤其在大数据场景下,减少并列判断可简化执行计划。

PixTV
PixTV

PixTV是一款面向AIGC内容创作的AI视频生成工具。

下载

怎样在Spark SQL中避免RANK全表排序的性能瓶颈

// 对比ROW_NUMBER与RANK的执行差异
val rowNumberSpec = Window.partitionBy($"category").orderBy($"score".desc)
val withRowNum = df.withColumn("row_num", row_number().over(rowNumberSpec))
withRowNum.show()

// 输出结果中,即使分数相同,row_num也唯一递增,而rank会重复

基于输入数据倾斜时的具体处理策略

当分区键存在严重数据倾斜(如某类别占比90%),即使使用`PARTITION BY`仍可能导致单个Task过载。此时应结合盐值(Salting)技术:为分区键添加随机前缀打散数据,排序后再去除前缀恢复原始结构。例如,对`category`列加`rand() % 10`作为临时键,排序后过滤掉盐值部分,从而平衡负载。

相关文章

数码产品性能查询
数码产品性能查询

该软件包括了市面上所有手机CPU,手机跑分情况,电脑CPU,电脑产品信息等等,方便需要大家查阅数码产品最新情况,了解产品特性,能够进行对比选择最具性价比的商品。

下载

相关标签:

性能瓶颈

本站声明:本文内容由网友自发贡献,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系admin@php.cn

相关专题

更多
大数据分析工具有哪四个
大数据分析工具有哪四个

大数据分析的四个工具分别是rapidminer、Hpcc、Hadoop和Pentaho bi。大数据分析用于从各种来源生成的原始数据中提取有价值的数据。这些数据帮助我们获得有意义的见解、隐藏的模式、未知的相关性、市场趋势等等,具体取决于行业。大数据分析的主要动机是提供有价值的见解,以便为未来做出更好的决策。php中文网为大家带来了大数据分析的相关教程、以及相关文章等内容,供大家免费下载使用。

2023.06.21

6576

5

Java 大数据处理基础(Hadoop 方向)

本专题聚焦 Java 在大数据离线处理场景中的核心应用,系统讲解 Hadoop 生态的基本原理、HDFS 文件系统操作、MapReduce 编程模型、作业优化策略以及常见数据处理流程。通过实际示例(如日志分析、批处理任务),帮助学习者掌握使用 Java 构建高效大数据处理程序的完整方法。

2025.12.08

1289

12

大数据专业学习教程
大数据专业学习教程

本专题整合了大数据专业学习相关教程,阅读专题下面的文章了解更多详细内容。

2026.01.05

243

5

python处理大数据合集
python处理大数据合集

本专题整合了python处理大数据相关教程,阅读专题下面的文章了解更多详细内容。

2026.01.05

546

22

数据分析工具有哪些
数据分析工具有哪些

数据分析工具有Excel、SQL、Python、R、Tableau、Power BI、SAS、SPSS和MATLAB等。详细介绍:1、Excel,具有强大的计算和数据处理功能;2、SQL,可以进行数据查询、过滤、排序、聚合等操作;3、Python,拥有丰富的数据分析库;4、R,拥有丰富的统计分析库和图形库;5、Tableau,提供了直观易用的用户界面等等。

2023.10.12

5083

8

SQL中distinct的用法
SQL中distinct的用法

SQL中distinct的语法是“SELECT DISTINCT column1, column2,...,FROM table_name;”。本专题为大家提供相关的文章、下载、课程内容,供大家免费下载体验。

2023.10.27

1031

4

SQL中months_between使用方法

在SQL中,MONTHS_BETWEEN 是一个常见的函数,用于计算两个日期之间的月份差。想了解更多SQL的相关内容,可以阅读本专题下面的文章。

2024.02.23

1329

5

SQL出现5120错误解决方法
SQL出现5120错误解决方法

SQL Server错误5120是由于没有足够的权限来访问或操作指定的数据库或文件引起的。想了解更多sql错误的相关内容,可以阅读本专题下面的文章。

2024.03.06

7161

10

sql procedure语法错误解决方法

sql procedure语法错误解决办法:1、仔细检查错误消息;2、检查语法规则;3、检查括号和引号;4、检查变量和参数;5、检查关键字和函数;6、逐步调试;7、参考文档和示例。想了解更多语法错误的相关内容,可以阅读本专题下面的文章。

2024.03.06

3803

4

热门下载

更多
网站特效
/
网站源码
/
网站素材
/
前端模板

精品课程

更多
相关推荐
/
热门推荐
/
最新课程
Swoole手册
Swoole手册

共0课时 | 0人学习