






在spark sql中,使用 row_number() 取top n数据需要结合窗口函数 over (partition by ... order by ...)。具体做法是:先按分组列分区、按排序列降序排列生成行号,再在外层查询中过滤行号为1到n的记录。这种方法能确保每个分组内只保留前n条记录,且结果稳定(若存在并列值需配合唯一键处理)。

如何为每个用户获取消费最高的前3笔订单
直接回答:通过 ROW_NUMBER() OVER(PARTITION BY user_id ORDER BY amount DESC) 生成序号并筛选 user_id 和 amount 的订单表,输出是每个用户金额最大的前3条订单记录。关键参数是分区字段 user_id 和排序字段 amount,若金额相同则按 order_id 进一步确定顺序以保证确定性。
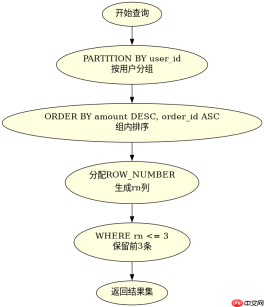
SELECT * FROM (
    SELECT
        order_id,
        user_id,
        amount,
        ROW_NUMBER() OVER(
            PARTITION BY user_id
            ORDER BY amount DESC, order_id ASC
        ) as rn
    FROM orders
) t WHERE rn <p>预期结果:假设用户A有5笔订单,金额分别为100, 90, 80, 70, 60,则返回金额100, 90, 80对应的三条记录。用户B同理。若某用户订单不足3笔,则返回其所有订单。</p><h2>如果存在并列金额,ROW_NUMBER会如何处理</h2><p>直接回答:<code>ROW_NUMBER()</code> 会为每一行分配唯一的连续整数,即使金额完全相同也会根据 <code>ORDER BY</code> 中的次要排序键(如 <code>order_id</code>)强制区分先后。因此不会出现两个行号都是1的情况,也不会跳过任何数字。这与 <code>RANK()</code> 或 <code>DENSE_RANK()</code> 不同,后者可能产生重复或跳跃的行号。</p><p><img src="https://img.php.cn/upload/article/000/969/633/179496192583767.png?x-oss-process=image/resize,p_40" alt="怎么在Spark SQL中使用ROW_NUMBER取Top N数据"></p><pre class="brush:php;toolbar:false;">-- 对比演示:相同金额下的行号分配
WITH sample AS (
    SELECT 'A' as user_id, 100 as amount, 1 as order_id UNION ALL
    SELECT 'A', 100, 2 UNION ALL
    SELECT 'A', 90, 3
)
SELECT
    order_id,
    amount,
    ROW_NUMBER() OVER(ORDER BY amount DESC, order_id) as rn,
    RANK() OVER(ORDER BY amount DESC) as rk,
    DENSE_RANK() OVER(ORDER BY amount DESC) as drk
FROM sample;
预期结果:第一行(order_id=1, amount=100)rn=1, rk=1, drk=1;第二行(order_id=2, amount=100)rn=2, rk=1, drk=1;第三行(order_id=3, amount=90)rn=3, rk=3, drk=2。可见 ROW_NUMBER 始终唯一,而 RANK 对并列项给相同排名并跳过后续名次。
当某个分组内记录数少于N时,查询结果会怎样
直接回答:查询会正常返回该分组内的所有记录,不会报错或填充空值。因为 WHERE rn 条件对所有存在的行都成立,只要行号小于等于N就会被保留。例如N=3,但某用户只有2笔订单,则这两笔订单的行号分别为1和2,均满足条件,全部返回。这是窗口函数的自然行为,无需额外处理。


