






在sql中,使用inner join精准更新库存预扣流水的核心做法是:将目标更新表与包含最新预扣数据的源表通过主键或关联字段进行内连接,并在update语句的from子句(或where子句中)指定连接条件。这样做可以直接基于源表的计算结果覆盖目标表中的旧数据,确保只更新那些在源表中存在且匹配的记录,从而避免全表扫描和逻辑错误。
如何构建基础的内连接更新语句
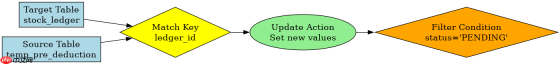
构建基础语句的关键在于明确“谁被更新”和“用什么更新”。通常,我们需要一个包含实时库存变动计算的临时表或CTE(公用表表达式),然后将其与库存流水表进行INNER JOIN。例如,假设我们有一个名为 stock_ledger 的目标表和一个名为 temp_pre_deduction 的源表,我们可以通过 ledger_id 将它们连接起来。这种写法能确保只有当两个表中都存在相同的 ledger_id 时,更新才会发生,从而实现了“精准”定位。
UPDATE stock_ledger sl
INNER JOIN temp_pre_deduction tpd ON sl.ledger_id = tpd.ledger_id
SET sl.pre_deduct_amount = tpd.new_deduct_value,
    sl.update_time = NOW()
WHERE sl.status = 'PENDING';
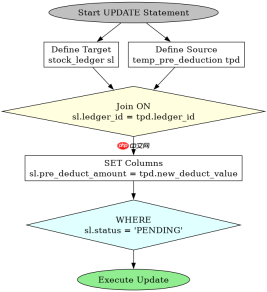
上述代码展示了标准的MySQL语法结构。首先,UPDATE 关键字后紧跟目标表别名 sl。接着,INNER JOIN 引入源表 tpd,并通过 ON 子句定义关联键。在 SET 子句中,我们引用源表的列 tpd.new_deduct_value 来更新目标表的列 sl.pre_deduct_amount。最后的 WHERE 子句进一步过滤,确保只更新状态为 PENDING 的记录,防止误更新已完成的流水。执行此语句后,所有匹配的待处理流水记录都将获得最新的预扣金额。
如何处理多对一关系下的数据聚合
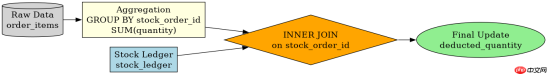
当源数据存在多条记录对应同一笔库存流水时,直接JOIN会导致数据膨胀或更新冲突。此时,必须先在源表中进行聚合操作,确保每个关联键只产生一行结果。例如,如果 order_items 表中有多个商品行对应同一个 stock_order_id,我们需要先按 stock_order_id 分组并求和,生成一个唯一的汇总视图,再与库存表进行INNER JOIN。这种方法保证了更新的原子性和准确性,避免了因一对多关系导致的重复计算。
UPDATE stock_ledger sl
INNER JOIN (
    SELECT stock_order_id, SUM(quantity) as total_qty
    FROM order_items
    GROUP BY stock_order_id
) oi_agg ON sl.stock_order_id = oi_agg.stock_order_id
SET sl.deducted_quantity = oi_agg.total_qty;
在这个示例中,子查询 (SELECT ... GROUP BY ...) 充当了中间层,它将原始的明细数据聚合为每个订单的唯一总数量。外层UPDATE语句将这个聚合后的结果集作为源表,与 stock_ledger 进行INNER JOIN。由于子查询的结果集中每个 stock_order_id 都是唯一的,因此JOIN操作不会产生笛卡尔积,每条流水记录只会匹配到一行聚合数据。最终,deducted_quantity 被准确更新为该订单下所有商品的总数量。这种模式在处理复杂业务逻辑时非常关键,它确保了数据一致性。
当源表不存在匹配记录时更新行为是什么
在使用INNER JOIN进行更新时,如果源表中不存在与目标表关联键匹配的记录,那么目标表中对应的行将不会被更新。这是因为INNER JOIN的定义是仅返回两个表中连接字段相等的行。任何在源表中找不到匹配项的目标表记录,都会从更新操作中排除。这意味着,如果你希望未找到匹配的记录保持原状,INNER JOIN是安全的选择;但如果你希望将这些未匹配的记录也进行某种默认值的更新,则需要改用LEFT JOIN或在外部逻辑中处理。


