






在sql聚合查询中无法直接引用开窗函数的别名,是因为sql语句的逻辑执行顺序决定了别名在当前层级不可见。具体来说,select子句的求值晚于where、group by和having子句,而开窗函数作为标量计算在select阶段才完成,因此后续的过滤或分组逻辑无法提前获取其结果。要解决这个问题,必须将包含开窗函数的查询封装为子查询(派生表)或使用cte,然后在外部查询中对生成的列进行过滤或聚合。
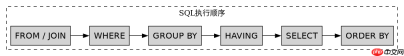
为什么HAVING子句不能直接使用SELECT中的别名?
HAVING子句用于过滤分组后的数据,但其执行顺序位于SELECT之前。当你在SELECT中定义了一个开窗函数别名(如 row_num),该别名仅在SELECT列表构建完成后才存在。HAVING子句试图在分组阶段就访问这个尚未计算的别名,导致数据库引擎报错“无效标识符”。正确的做法是在外层查询中过滤,或者在HAVING中使用完整的开窗函数表达式(但这通常效率低下且难以维护)。
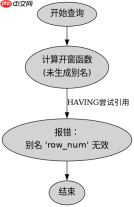
SELECT department, AVG(salary) as avg_sal
FROM employees
GROUP BY department
HAVING ROW_NUMBER() OVER (PARTITION BY department ORDER BY salary DESC) = 1;
-- 错误:HAVING中不能直接使用SELECT定义的别名
-- 正确做法是使用子查询
如何在聚合查询中基于开窗结果进行过滤?
要在聚合或过滤逻辑中使用开窗函数的结果,最标准的方法是将开窗查询作为子查询。内层查询负责计算每行的排名或累计值并赋予别名,外层查询则像处理普通表一样,对这些别名进行WHERE过滤或进一步聚合。这种方法利用了SQL的执行计划优化,确保开窗计算只进行一次,然后在外层应用过滤条件,既符合语法规范又保证性能。
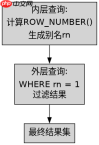
-- 示例:找出每个部门薪资最高的员工
WITH RankedEmployees AS (
    SELECT
        department,
        name,
        salary,
        ROW_NUMBER() OVER (PARTITION BY department ORDER BY salary DESC) as rn
    FROM employees
)
SELECT department, name, salary
FROM RankedEmployees
WHERE rn = 1;
如果必须在同一层级使用开窗结果,有哪些替代方案?
虽然不能直接引用别名,但可以通过重复编写开窗函数表达式来绕过限制,不过这会降低可读性并可能影响性能。另一种更优雅的替代方案是使用CTE(公共表表达式),它将逻辑分层,使主查询清晰易懂。此外,对于简单的排序过滤,有时可以使用窗口函数结合LATERAL连接或JSON聚合等高级特性,但这些方法依赖于特定数据库的支持。核心原则是:始终记住SELECT别名的作用域仅限于当前SELECT列表及之后的ORDER BY,无法回溯到WHERE或HAVING。


