






在sql中对分组聚合后的数据进行降序排名,最直接且高效的方法是使用窗口函数 rank() 或 dense_rank()。你需要在查询中指定 partition by 子句来定义分组的依据(如部门、类别),并在 order by 子句中指定按哪个聚合结果进行降序排列(如 desc)。这样数据库引擎会在内存中直接计算每个分组内的相对位置,无需自连接或临时表,从而获得最佳的执行性能。

RANK() 与 DENSE_RANK() 在并列处理上的区别是什么
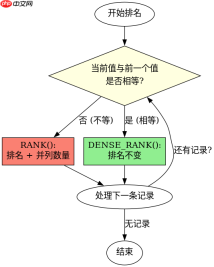
当分组内存在多个具有相同聚合值的记录时,RANK() 和 DENSE_RANK() 会给出不同的排名结果。RANK() 会产生“跳跃式”排名,即如果有两条记录并列第1名,下一条记录的排名将是第3名;而 DENSE_RANK() 则是“连续式”排名,并列第1名后,下一条记录依然是第2名。选择哪种函数取决于业务逻辑是否需要保留排名的间隙。
SELECT
    department,
    employee_name,
    total_sales,
    RANK() OVER (PARTITION BY department ORDER BY total_sales DESC) as rank_with_gaps,
    DENSE_RANK() OVER (PARTITION BY department ORDER BY total_sales DESC) as dense_rank_continuous
FROM (
    SELECT
        d.name as department,
        e.name as employee_name,
        SUM(s.amount) as total_sales
    FROM employees e
    JOIN sales s ON e.id = s.employee_id
    JOIN departments d ON e.dept_id = d.id
    GROUP BY d.name, e.name
) AS aggregated_data;
假设输入数据中,销售部有两名员工销售额均为 10000,另一名员工为 8000。使用 RANK() 时,前两名员工排名均为 1,第三名员工排名为 3。使用 DENSE_RANK() 时,前两名员工排名均为 1,第三名员工排名为 2。这验证了两种函数在处理并列值时的不同行为。
如何处理分组后聚合值为 NULL 的排名情况
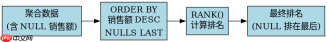
在分组聚合过程中,如果某些组内的聚合结果为 NULL(例如某部门没有销售记录,SUM 结果为 NULL),这些记录在排名中的位置取决于 ORDER BY 的方向。默认情况下,NULL 值被视为最小值,因此在降序(DESC)排列时,NULL 值会排在最后。如果需要将 NULL 值视为最大值并排在最前面,可以使用 NULLS LAST 或 NULLS FIRST 语法(具体支持情况因数据库而异,如 PostgreSQL 支持 NULLS LAST,Oracle 支持 NULLS FIRST)。
SELECT
    department,
    employee_name,
    total_sales,
    RANK() OVER (PARTITION BY department ORDER BY total_sales DESC NULLS LAST) as rank_nulls_last
FROM (
    SELECT
        d.name as department,
        e.name as employee_name,
        SUM(s.amount) as total_sales
    FROM employees e
    LEFT JOIN sales s ON e.id = s.employee_id
    JOIN departments d ON e.dept_id = d.id
    GROUP BY d.name, e.name
) AS aggregated_data;
-- 注意:此处使用 LEFT JOIN 以包含无销售记录的部门/员工,SUM 结果为 NULL
在上述代码中,通过 LEFT JOIN 确保即使没有销售记录,部门和员工信息也会被保留,此时 total_sales 为 NULL。在 ORDER BY total_sales DESC NULLS LAST 中,NULL 值被显式地排在最后。如果省略 NULLS LAST,在某些数据库中 NULL 可能排在最前或最后,行为不一致。明确指定排序规则可确保排名结果的确定性。


