






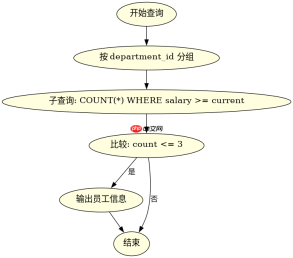
在sql中通过嵌套子查询解决分组取top n问题,核心思路是利用相关子查询统计当前行在其分组内满足特定排序条件的排名,并筛选出排名小于等于n的记录。具体做法是在select列表或where子句中嵌入一个count(*)子查询,该子查询对同一分组(group by字段)且排序值优于或等于当前行的记录进行计数,当计数结果不超过目标n时,该行即为top n之一。这种方法适用于大多数支持标准sql语法的数据库系统,能够灵活处理并列排名的情况。

如何编写基于相关子查询的Top N SQL语句
编写基于相关子查询的Top N SQL语句,需要在主查询中指定分组列和排序列,并在WHERE子句中使用相关子查询计算每行在组内的排名。例如,要获取每个部门工资最高的前3名员工,可以使用如下结构:主查询选择员工信息,子查询统计同部门中工资大于等于当前员工工资的 record 数量,若该数量小于等于3,则保留该行。关键在于子查询必须引用主查询的分组字段和排序字段,以形成相关性。
SELECT e1.department_id, e1.employee_name, e1.salary
FROM employees e1
WHERE (
    SELECT COUNT(*)
    FROM employees e2
    WHERE e2.department_id = e1.department_id
      AND e2.salary >= e1.salary
) <p>上述代码假设表名为employees,包含department_id、employee_name和salary字段。运行后,对于每个department_id,将返回salary最高的前3条记录。如果存在相同工资的员工,它们都会被计入排名,可能导致某组返回超过3条记录。若需严格限制为N条,可结合ROW_NUMBER()窗口函数,但本题聚焦于子查询方案。预期输出为每个部门最多3名高工资员工,按部门ID和工资降序排列。</p><h2>如何处理并列排名导致的记录数超出N的情况</h2><p>处理并列排名导致的记录数超出N的情况,可以通过调整子查询中的比较运算符来实现。默认情况下,使用>=运算符会包括所有并列的记录,从而可能使结果集超过N条。若希望严格限制每组恰好N条记录,即使存在并列,也应只取前N个唯一排序值对应的记录,这通常需要更复杂的逻辑,如先确定第N高的阈值,再筛选。但在简单场景下,接受并列导致的多记录是常见做法。另一种方法是使用DENSE_RANK()或RANK()窗口函数,但题目要求使用嵌套子查询,因此我们可通过修改子查询条件来近似控制。</p><p><img src="https://img.php.cn/upload/article/000/969/633/179496334142979.png?x-oss-process=image/resize,p_40" alt="怎么在SQL中通过嵌套子查询解决分组取Top N问题"></p><pre class="brush:php;toolbar:false;">-- 示例:获取每个部门工资严格前三高的不同薪资水平对应的员工
-- 注意:此方法仍可能因并列而返回多行,但若目标是按薪资等级取Top N,则有效
SELECT e1.department_id, e1.employee_name, e1.salary
FROM employees e1
WHERE (
    SELECT COUNT(DISTINCT e2.salary)
    FROM employees e2
    WHERE e2.department_id = e1.department_id
      AND e2.salary >= e1.salary
) <p>在上述代码中,子查询使用COUNT(DISTINCT e2.salary)而非COUNT(*),这样即使有多个员工具有相同最高工资,也只计为一个排名。这确保了每个部门只返回工资最高的前三个不同薪资水平对应的所有员工。例如,若某部门有两名员工工资均为最高,则他们都会被包含,但不会因第三名工资相同而额外增加记录数超过三个薪资等级。预期输出中,每个部门的记录数取决于其内部薪资分布,但薪资等级总数不超过3。这种方法平衡了并列处理和结果可控性,适用于需要按层级取样的场景。</p><h2>当子查询中分组字段为空时会发生什么</h2><p>当子查询中分组字段为空时,相关子查询的行为取决于数据库系统对NULL值的处理。在标准SQL中,NULL与任何值(包括NULL)的比较结果均为UNKNOWN,因此在WHERE子句中,e2.department_id = e1.department_id当e1.department_id为NULL时,条件不成立,导致子查询返回0。这意味着主查询中该行的排名计数为0,若N>=0,则该行会被保留。然而,这可能导致空分组字段被错误地归类为“排名第一”,因为COUNT(*)为0小于等于N。为避免此问题,应在主查询中过滤掉分组字段为NULL的行,或在子查询中添加IS NULL判断。例如,修改子查询条件为(e2.department_id = e1.department_id OR (e2.department_id IS NULL AND e1.department_id IS NULL)),以确保NULL值正确分组。</p>


