






在oracle中使用bulk collect优化大数据量游标性能,核心做法是结合limit子句分批抓取数据,避免一次性加载导致pga内存溢出或ora-01555错误。具体实现时,需定义一个固定大小的集合类型,在循环中通过fetch ... bulk collect into ... limit n将数据批量拉取到pl/sql集合中,随后对集合进行批量处理(如forall插入),最后检查退出条件。这样做能显著减少上下文切换次数,提升i/o效率,同时通过控制单次抓取量保持内存稳定。

BULK COLLECT 的基本语法与集合定义
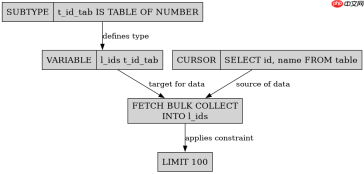
要使用BULK COLLECT,首先必须定义PL/SQL集合类型,通常使用TABLE OF记录或独立字段。基本语法结构为FETCH cursor_name BULK COLLECT INTO collection_name [LIMIT rows]。如果不加LIMIT,Oracle会尝试获取所有行,这在大数据量下极易引发内存不足。因此,定义集合后,关键在于如何在循环中正确声明和初始化这些集合变量,确保它们能够容纳批量数据。
DECLARE
  TYPE t_id_tab IS TABLE OF employees.employee_id%TYPE;
  TYPE t_name_tab IS TABLE OF employees.first_name%TYPE;

  l_ids   t_id_tab;
  l_names t_name_tab;

  CURSOR c_emp IS
    SELECT employee_id, first_name
    FROM employees;
BEGIN
  OPEN c_emp;
  LOOP
    FETCH c_emp BULK COLLECT
      INTO l_ids, l_names
      LIMIT 100; -- 每次抓取100行

    EXIT WHEN c_emp%NOTFOUND;

    -- 此处可添加对l_ids和l_names的处理逻辑
    FOR i IN 1 .. l_ids.COUNT LOOP
      DBMS_OUTPUT.PUT_LINE(l_ids(i) || ': ' || l_names(i));
    END LOOP;
  END LOOP;
  CLOSE c_emp;
END;
上述代码展示了标准的BULK COLLECT模式。定义了ID和姓名的两个嵌套表类型。游标查询返回两列。在循环内部,FETCH语句同时将数据填充到两个集合中。LIMIT 100限制了单次操作的数据量。当FETCH没有返回任何行时,%NOTFOUND变为TRUE,循环退出。这种结构确保了即使表中有一百万行数据,内存中也只保留最近处理的100行数据。
结合 FORALL 实现批量写入优化
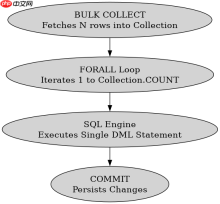
单纯读取数据使用BULK COLLECT已经比逐行处理快得多,但如果目的是将数据从一张表迁移到另一张表,或者进行大量更新/删除,必须配合FORALL语句。FORALL允许将PL/SQL集合中的数据一次性发送到SQL引擎执行,进一步减少了PL/SQL与SQL引擎之间的上下文切换。这是优化大数据量DML操作的关键步骤。若只使用BULK COLLECT读取而不使用FORALL写入,整体性能提升有限,因为写入环节仍然是逐行执行的瓶颈。

DECLARE
  TYPE t_emp_rec IS TABLE OF employees%ROWTYPE;
  l_emps t_emp_rec;

  CURSOR c_big_data IS
    SELECT * FROM employees WHERE department_id = 10;
BEGIN
  OPEN c_big_data;
  LOOP
    FETCH c_big_data BULK COLLECT INTO l_emps LIMIT 500;
    EXIT WHEN c_big_data%NOTFOUND;

    -- 使用 FORALL 批量插入目标表
    FORALL i IN 1 .. l_emps.COUNT
      INSERT INTO employees_archive (employee_id, first_name, last_name, salary)
      VALUES (l_emps(i).employee_id, l_emps(i).first_name, l_emps(i).last_name, l_emps(i).salary);

    COMMIT; -- 根据业务需求决定提交频率
  END LOOP;
  CLOSE c_big_data;
END;
这段代码演示了完整的读写优化流程。定义了一个基于%ROWTYPE的集合,以匹配源表结构。在循环中,每次抓取500行数据到集合l_emps中。紧接着,使用FORALL语句遍历该集合,执行INSERT操作。注意FORALL的索引范围是1到集合当前计数值。这种方式将500次独立的INSERT合并为一次批量操作,极大地提高了写入速度。在实际生产中,还需考虑COMMIT的频率,避免因事务过大导致Undo表空间压力。
LIMIT参数对内存与性能的具体影响
在使用BULK COLLECT时,LIMIT参数的选择直接决定了程序的稳定性和最终性能。如果LIMIT设置过小,虽然内存占用极低,但上下文切换次数增加,导致CPU开销上升;如果设置过大或省略LIMIT,一旦遇到超大结果集,可能会耗尽PGA内存,导致ORA-04030错误或数据库实例挂起。因此,需要根据服务器可用内存和数据行大小动态调整LIMIT值。通常建议从100到1000之间开始测试,观察V$PGASTAT视图中的PGA内存使用情况,找到平衡点。
,



