sql中对大文本字段进行join关联极易引发性能瓶颈,核心原因在于数据库无法有效利用索引进行快速定位,且必须执行高开销的字符串比较操作。具体做法是避免在join条件中使用text或longtext等大文本类型,转而使用定长或短变长字段(如varchar)建立外键索引,或者将大文本内容移至子查询/临时表中处理后再关联。若强行对大文本字段join,数据库通常会退化为全表扫描和文件排序,导致cpu飙升、内存溢出及i/o等待。
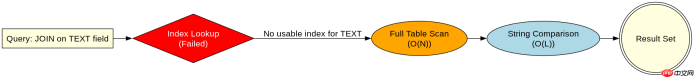
为什么大文本JOIN会导致索引失效与全表扫描
当JOIN条件涉及大文本字段时,B+树索引的结构特性决定了其无法高效工作。B+树索引依赖于有序性和固定长度的键值来快速导航,而大文本字段(如MySQL的TEXT或PostgreSQL的TEXT)通常长度不固定且远超索引页大小。数据库引擎在处理这类JOIN时,往往无法直接使用索引进行范围查找或等值匹配,而是被迫回退到全表扫描(Full Table Scan)。这意味着每一行数据都需要被读取并参与比较,极大地增加了I/O开销。此外,即使某些数据库支持前缀索引,JOIN操作通常需要完整的字符串匹配,前缀索引在此场景下毫无用处。
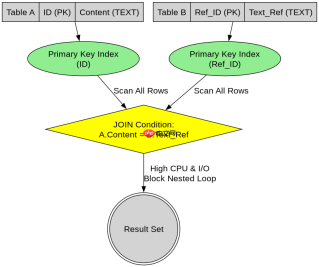
CREATE TABLE large_text_table ( id INT PRIMARY KEY, content TEXT NOT NULL ); CREATE TABLE reference_table ( ref_id INT PRIMARY KEY, text_ref TEXT NOT NULL ); -- 错误的JOIN方式:直接对TEXT字段进行JOIN SELECT * FROM large_text_table ltt JOIN reference_table rt ON ltt.content = rt.text_ref; -- 这种写法会导致两个表都进行全表扫描,并在内存或磁盘中进行大量的字符串比对
预期结果:执行计划显示类型为ALL,Extra包含Using join buffer (Block Nested Loop)或Using filesort。由于没有索引可用,数据库必须加载所有数据块,逐行比较TEXT内容,随着数据量增加,耗时呈指数级增长。
如何通过引入ID映射解决JOIN性能问题
解决大文本JOIN性能问题的标准做法是“空间换时间”与“解耦”。具体做法是在业务逻辑层或应用代码中,为大文本内容生成唯一的标识符(如UUID、自增ID或哈希值),并将该标识符作为外键存储在关联表中。在SQL层面,仅对这些短小的标识符字段进行JOIN操作。这样,数据库可以利用B+树索引快速定位记录,将O(N*M)的字符串比较复杂度降低为O(log N + log M)的索引查找复杂度。如果确实需要基于文本内容动态关联,可以先通过子查询计算出唯一ID,再在主查询中进行JOIN,从而避免直接在JOIN条件中计算大文本。

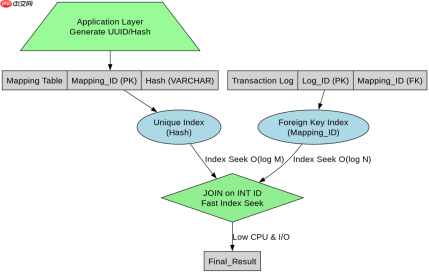
-- 优化后的方案:使用ID进行关联 CREATE TABLE text_mapping ( mapping_id INT PRIMARY KEY AUTO_INCREMENT, content_hash VARCHAR(64) UNIQUE NOT NULL, original_content TEXT ); CREATE TABLE transaction_log ( log_id INT PRIMARY KEY, mapping_id INT, FOREIGN KEY (mapping_id) REFERENCES text_mapping(mapping_id) ); -- 正确的JOIN方式:基于INT类型的ID进行关联 SELECT tm.original_content, tl.log_id FROM transaction_log tl JOIN text_mapping tm ON tl.mapping_id = tm.mapping_id;
预期结果:执行计划显示类型为ref或eq_ref,使用主键或唯一索引。JOIN操作变得极快,因为比较的是固定长度的整数或短字符串,而非巨大的文本块。内存占用显著降低,因为不需要在Join Buffer中缓存大量文本数据。
当必须基于部分文本内容匹配时该如何处理
如果业务场景强制要求基于大文本的部分内容进行关联(例如模糊匹配或特定子串提取),直接JOIN是不可行的。此时应改用正则表达式函数或内置的全文检索功能。具体做法是使用`SUBSTRING_INDEX`、`REGEXP`或数据库特定的全文索引(如MySQL的FULLTEXT)来预处理文本,提取出可用于JOIN的关键字或ID。例如,可以从URL中提取域名部分,从日志中提取错误码,然后将这些提取出的短字符串存入独立字段并建立索引,最后基于这些新字段进行JOIN。这种方法避免了直接操作原始大文本,同时满足了基于内容关联的需求。