






在postgresql中,利用 copy 命令代替常规 insert 是提升大批量数据导入性能的最佳实践。具体做法是将数据写入csv或纯文本文件,然后执行 copy table_name from 'file_path' 语句。该命令通过绕过sql解析器并启用批量插入模式,显著减少i/o开销和事务日志生成,从而实现比逐行 insert 更快的加载速度。
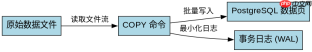
COPY命令与INSERT的性能差异机制是什么
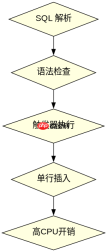
COPY 命令之所以快,是因为它直接读取文件流并批量写入数据页,而 INSERT 需要为每行执行完整的SQL解析、语法检查和触发器检查。对于数百万行的数据,这种差异尤为明显。
CREATE TABLE users (id SERIAL PRIMARY KEY, name TEXT, email TEXT);COPY users (name, email) FROM '/tmp/users.csv' WITH (FORMAT csv, HEADER true);SELECT count(*) FROM users;
预期结果:表 users 中包含来自CSV文件的所有记录,且导入时间远少于等效的 INSERT 语句集合。
如何处理COPY导入时的权限与路径问题
使用 COPY ... FROM 时,数据库服务器进程必须能访问指定路径的文件。这通常意味着需要将文件放在服务器本地,或使用 COPY ... FROM STDIN 配合客户端工具如 psql 进行管道传输。此外,执行用户需具备表的 INSERT 权限及文件的读取权限。

\copy users (name, email) FROM '/tmp/users.csv' CSV HEADER;SELECT * FROM users LIMIT 5;
预期结果:通过 \copy 元命令,客户端将文件内容发送给服务器,避免了服务器端路径限制,成功导入数据。
COPY命令在处理空值时会返回什么默认行为
当CSV文件中存在连续逗号或特定标记时,COPY 会将对应字段视为NULL。若未指定 NULL 选项,默认将字符串 '\N' 识别为空值。这一行为确保了数据完整性,但需注意源数据格式是否匹配默认设置。


