






使用 select distinct 导致查询变慢,通常是因为数据库需要对结果集进行额外的排序或哈希去重操作。解决这一问题的核心思路是避免不必要的去重计算,或者优化去重的执行计划。具体做法包括:检查是否可以通过业务逻辑消除重复数据源、利用索引覆盖扫描减少回表、或者将 distinct 替换为 group by 以利用更高效的聚合算法。如果必须去重,确保参与去重的列上有合适的索引,并考虑调整 sort_buffer_size 等内存参数。
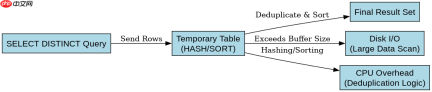
为什么DISTINCT比直接查询慢?
SELECT DISTINCT 的性能瓶颈主要源于数据库引擎在返回结果前必须对数据进行去重处理。对于大多数关系型数据库(如 MySQL),这通常意味着需要创建一个临时表,并对所有选定的列进行排序或构建哈希表。如果数据量很大且无法通过索引快速定位唯一值,数据库可能不得不读取大量磁盘数据并进行全表扫描后的排序,导致 CPU 和 I/O 开销显著增加。相比之下,直接查询只需按顺序或索引路径获取数据,无需额外的去重计算步骤。
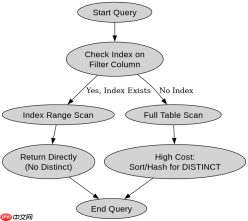
CREATE TABLE users ( id INT PRIMARY KEY, email VARCHAR(255), status VARCHAR(50) ); INSERT INTO users VALUES (1, 'a@b.com', 'active'), (2, 'a@b.com', 'inactive'), (3, 'c@d.com', 'active'); -- 慢查询:需要去重 SELECT DISTINCT email FROM users; -- 快查询:假设业务允许只取最新状态,利用索引或直接过滤 SELECT email FROM users WHERE status = 'active';
上述代码中,SELECT DISTINCT email 会扫描整个 users 表,将所有 email 放入临时结构中去重。而第二个查询如果 status 有索引,可以直接通过索引范围扫描获取数据,完全避免了去重开销。预期结果是第一个查询耗时较长,第二个查询极快。
如何用GROUP BY替代DISTINCT提升性能?
在许多场景下,GROUP BY 可以替代 DISTINCT 并获得更好的性能,因为现代数据库优化器对聚合操作的优化往往优于通用的去重逻辑。GROUP BY 允许数据库在分组的同时进行其他聚合计算(如计数、求和),从而在一次遍历中完成更多工作。此外,GROUP BY 更容易与索引结合,特别是当分组列也是索引的前导列时,数据库可以利用索引的顺序性直接生成分组结果,避免显式的排序步骤。需要注意的是,GROUP BY 和 DISTINCT 在语义上略有不同,GROUP BY 通常用于聚合上下文,但在仅选择非聚合列时,其效果等同于 DISTINCT。
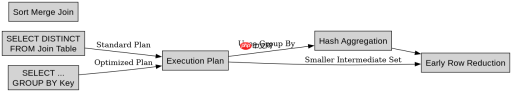
-- 原始DISTINCT查询 SELECT DISTINCT u.id, u.name FROM users u JOIN orders o ON u.id = o.user_id; -- 优化为GROUP BY SELECT u.id, u.name FROM users u JOIN orders o ON u.id = o.user_id GROUP BY u.id, u.name;
在这段代码中,两个查询都旨在获取有订单的用户列表。使用 GROUP BY 后,数据库优化器可能会选择更高效的哈希聚合或排序聚合策略。特别是在连接操作中,GROUP BY 可以帮助提前缩小中间结果集的大小。预期结果是两者返回相同的数据集,但 GROUP BY 版本在执行计划中可能显示为更优的聚合操作,而非简单的去重排序。
基于索引覆盖如何进一步优化去重查询?
当去重查询涉及的列恰好构成一个联合索引时,数据库可以利用“索引覆盖”技术极大提升性能。在这种情况下,数据库无需访问主键聚簇索引对应的数据行,只需扫描索引树即可获取所有需要的值并进行去重。由于索引通常比数据行小得多,且有序排列,去重过程可以在内存中高效完成,甚至避免磁盘 I/O。例如,如果有一个针对 (email, status) 的联合索引,查询 SELECT DISTINCT email FROM users 就可以直接扫描该索引,跳过 status 列的实际数据读取,从而显著减少资源消耗。关键在于确保去重列包含在某个可用索引的前缀中。
CREATE INDEX idx_email_status ON users (email, status); -- 利用索引覆盖进行去重 SELECT DISTINCT email FROM users;
此例中,idx_email_status 索引包含了 email 列。执行 SELECT DISTINCT email 时,优化器会选择扫描此索引,因为索引条目已经按 email 排序,去重变得极其廉价。预期结果是查询执行时间大幅缩短,且 EXPLAIN 输出中应显示 Using index,表明未访问实际数据行。


