






在php中强制下载文件并解决文件名乱码,核心做法是设置正确的http响应头,将`content-disposition`中的文件名使用rfc 5987标准进行编码。具体而言,需调用`header()`函数设置`content-type`为`application/octet-stream`,并将`content-disposition`的值设为`attachment; filename*=utf-8''[url编码后的文件名]`。这样做能确保现代浏览器正确解析非ascii字符(如中文),同时保持对旧版浏览器的兼容。

header()如何构造下载响应头
直接回答:通过组合`Content-Type`和`Content-Disposition`两个头部字段,可以触发浏览器的下载行为。关键在于`filename*`参数的使用,它允许指定字符集和URL编码格式,从而避免乱码。
<?php // 假设文件名包含中文
$filename = '测试文档.pdf';

// 1. 设置内容类型,强制二进制流下载
header('Content-Type: application/octet-stream');

// 2. 设置内容长度(可选,但推荐)
header('Content-Length: ' . filesize($filename));

// 3. 关键:处理文件名编码
// 使用 RFC 5987 标准: filename*=charset'language'encoded_value
// UTF-8 编码后,空格变为 %20,其他特殊字符同理
$encodedFilename = rawurlencode($filename);
header("Content-Disposition: attachment; filename=\"{$filename}\"; filename*=UTF-8''{$encodedFilename}");

// 4. 输出文件内容
readfile($filename);
exit;
?>
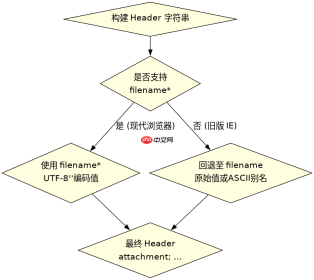
上述代码首先声明了二进制流类型,防止浏览器尝试渲染。接着计算文件大小以便显示进度。最关键的是第三行,`filename`属性保留原始名称以兼容老旧浏览器,而`filename*`属性使用`UTF-8`标识和URL编码值,这是解决乱码的标准方案。执行此脚本后,浏览器会弹出保存对话框,文件名显示为“测试文档.pdf”而非乱码。
不同浏览器对filename*的支持差异
直接回答:虽然`filename*`是现代标准,但部分旧版IE浏览器不支持该参数,甚至可能因忽略它而回退到错误的`filename`解析逻辑。因此,必须同时提供双份`filename`定义,并确保顺序正确。

<?php // 模拟不同浏览器的解析逻辑
function simulateBrowserParse($headerValue) {
    // 提取 filename* 部分
    preg_match('/filename\*=UTF-8\'\'(.+?)(?:;|$)/', $headerValue, $matchesStar);
    $starName = isset($matchesStar[1]) ? urldecode($matchesStar[1]) : null;

    // 提取 filename 部分
    preg_match('/filename="([^"]+)"/', $headerValue, $matchesNorm);
    $normName = isset($matchesNorm[1]) ? $matchesNorm[1] : null;

    return [
        'rfc5987_name' => $starName,
        'legacy_name' => $normName,
        'final_choice' => $starName ?? $normName
    ];
}

$header = 'attachment; filename="test.pdf"; filename*=UTF-8\'\'test.pdf';
$result = simulateBrowserParse($header);
print_r($result);
?>
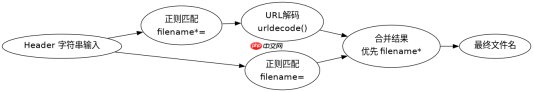
这段代码模拟了浏览器解析头部字符串的过程。现代浏览器(Chrome, Firefox, Edge)优先读取`filename*`并进行URL解码,得到正确的中文或特殊字符文件名。旧版IE(如IE9及以下)可能完全忽略`filename*`,转而尝试解析`filename`。如果`filename`中包含未转义的特殊字符,IE可能会截断文件名或产生乱码。因此,最佳实践是始终同时发送两者,且`filename`应尽可能简单或使用纯ASCII别名,而将复杂名称留给`filename*`。这种双重保障机制确保了广泛的兼容性。
当文件路径包含空格时如何处理
直接回答:如果源文件路径本身包含空格,`rawurlencode()`会对整个文件名进行编码,包括空格变为`%20`。这在大多数情况下是安全的,但需注意某些服务器配置或中间件可能对URL编码后的路径有特殊处理。建议在使用`readfile()`前,先通过`realpath()`获取绝对路径,避免因相对路径中的空格导致文件查找失败。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





