






php强制下载文件的核心做法是设置正确的http响应头并读取文件流,关键步骤包括使用content-disposition头指定文件名、设置content-type为application/octet-stream以触发下载,并通过readfile()或循环读取输出内容。必须对输入的文件路径进行严格校验以防止目录遍历攻击,并确保在发送任何输出前调用header()函数。
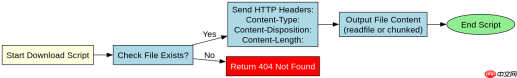
如何正确设置HTTP响应头以触发浏览器下载行为
要触发浏览器的下载对话框而非直接打开文件,必须向客户端发送特定的HTTP头部信息。首要的是Content-Type,通常设置为application/octet-stream,这告诉浏览器这是一个二进制流,不应尝试解析或显示。其次是Content-Disposition,其值应包含attachment关键字以及filename参数,后者指定了保存时的默认文件名。如果文件名包含非ASCII字符(如中文),需要使用RFC 5987标准中的filename*=UTF-8''...格式进行编码,以确保兼容性。此外,还需要设置Content-Length告知文件大小,以及Cache-Control和Pragma禁止缓存,防止敏感文件被意外存储。
<?php // 假设 $filePath 是服务器上的实际路径,$fileName 是希望用户看到的名称
$filePath = '/var/www/data/report.pdf';
$fileName = '年度报告.pdf';

if (!file_exists($filePath)) {
    http_response_code(404);
    exit('File not found');
}

// 清除所有之前的输出
ob_clean();
flush();

// 设置 MIME 类型
header('Content-Type: application/octet-stream');

// 设置 Content-Disposition,处理中文文件名
header('Content-Disposition: attachment; filename="' . urlencode($fileName) . '"; filename*=UTF-8'\'' . urlencode($fileName) . '\'' );

// 禁止缓存
header('Cache-Control: no-store, no-cache, must-revalidate');
header('Pragma: no-cache');

// 获取文件大小
header('Content-Length: ' . filesize($filePath));

// 输出文件内容
readfile($filePath);
exit;
?>
上述代码首先检查文件是否存在,若不存在则返回404错误。接着清理输出缓冲区,确保没有意外的HTML或空格混入响应头。然后依次设置MIME类型、内容处置(包含URL编码和UTF-8扩展)、缓存控制策略以及文件大小。最后通过readfile()将文件内容直接写入输出缓冲,并立即退出脚本,防止后续代码干扰下载过程。
如何验证文件路径安全性以防止目录遍历漏洞
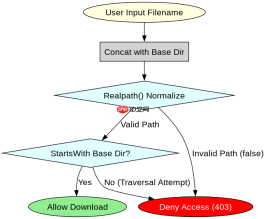
在处理用户提供的文件名或路径时,最大的安全风险是目录遍历(Directory Traversal)。攻击者可能通过构造类似../../../etc/passwd的路径来访问服务器上的敏感文件。因此,必须在代码中实施严格的路径验证。最佳实践是使用realpath()函数将相对路径转换为绝对路径,并结合白名单机制或基础目录限制。例如,可以规定所有下载的文件必须位于某个特定目录下,然后检查解析后的绝对路径是否以该基础目录开头。同时,应避免直接使用用户输入作为include或require的目标,虽然这里主要涉及文件下载,但原理相同。对于数据库查询得到的文件ID,应先查库获取真实路径,再结合白名单校验,而不是直接拼接用户输入。


<?php // 定义允许下载的根目录
$allowedBaseDir = realpath('/var/www/secure_downloads');

// 模拟用户输入的文件名
$userInput = '../config/database.yml';

// 构建完整路径
$fullPath = $allowedBaseDir . '/' . $userInput;

// 规范化路径,解决 .. 和 . 等问题
$normalizedPath = realpath($fullPath);

// 安全检查:确保规范化后的路径仍在允许的基目录下
if ($normalizedPath === false || strpos($normalizedPath, $allowedBaseDir) !== 0) {
    http_response_code(403);
    exit('Access denied: Invalid file path');
}

// 如果通过检查,则可以安全地提供下载
header('Content-Type: application/octet-stream');
header('Content-Disposition: attachment; filename="' . basename($normalizedPath) . '"');
readfile($normalizedPath);
exit;
?>
这段代码演示了如何安全地处理文件路径。首先定义一个安全的基目录$allowedBaseDir,并使用realpath()获取其绝对路径。接着,将用户输入与基目录拼接,形成潜在的文件路径。关键在于使用realpath()对最终路径进行规范化,这会解析掉所有的..和.符号,并验证文件是否存在。随后,使用strpos()检查规范化后的路径是否以允许的基目录开头。如果不是,说明用户试图跳出安全区域,程序拒绝访问并返回403错误。只有当路径完全合法且在白名单内时,才执行下载操作。这种方法能有效抵御目录遍历攻击。
大文件下载时内存溢出问题的解决方案
当下载的文件体积较大时,直接使用readfile()可能会导致PHP进程占用过多内存,甚至引发内存溢出错误。这是因为readfile()在某些配置下可能会尝试将整个文件加载到内存中,或者由于输出缓冲区的累积导致内存增长。为了解决这个问题,应采用分块读取的方式,即每次只读取文件的一小部分(例如8KB或64KB),然后立即输出到客户端,并刷新输出缓冲区。这样可以确保内存使用量保持在一个固定的低水平,无论文件多大。此外,还可以设置ignore_user_abort()允许用户在断开连接后服务器继续完成传输,以及使用set_time_limit()延长脚本执行时间,以防超时。
<?php $filePath = '/var/www/large_files/video.mp4';
$fileName = 'large_video.mp4';

if (!file_exists($filePath)) {
    http_response_code(404);
    exit('File not found');
}

ob_clean();
flush();

header('Content-Type: application/octet-stream');
header('Content-Disposition: attachment; filename="' . urlencode($fileName) . '"');
header('Content-Length: ' . filesize($filePath));
header('Cache-Control: no-store, no-cache, must-revalidate');
header('Pragma: no-cache');

// 允许脚本在用户断开后继续运行
ignore_user_abort(true);
// 设置较长的执行时间
set_time_limit(0);

// 分块读取并输出
$chunkSize = 8192; // 8KB
$handle = fopen($filePath, 'rb');
if ($handle === false) {
    exit('Cannot open file');
}

while (!feof($handle)) {
    echo fread($handle, $chunkSize);
    flush(); // 刷新输出缓冲区
}

fclose($handle);
exit;
?>
此代码片段展示了大文件下载的最佳实践。它首先设置了必要的HTTP头,然后启用ignore_user_abort()和set_time_limit(0)以支持长时间传输。核心逻辑是使用fopen()打开文件句柄,然后通过一个while循环,每次使用fread()读取8KB的数据,并通过echo输出,紧接着调用flush()将数据推送到客户端。这种方式确保了内存中始终只存在一小部分文件数据,从而避免了内存溢出。最后,关闭文件句柄并退出脚本。这种方法适用于任何大小的文件,尤其是GB级别的视频或备份文件。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





