






加密的php文件在记事本中显示为乱码是因为其内容经过了二进制编码或压缩,导致字节序列不再符合utf-8等文本编码规则。要查看加密特征,应使用支持十六进制查看功能的编辑器(如vs code配合hex editor插件、notepad++配合hex-editor插件或010 editor),通过观察文件头标识和结构模式来识别加密方式。
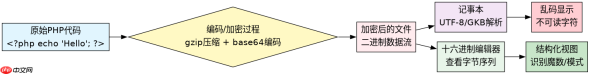
为什么记事本打开会显示乱码
记事本默认使用系统编码(如Windows下的GBK或UTF-8)解析文本,而加密后的PHP文件通常经过base64编码、gzip压缩或自定义二进制混淆,这些操作将原始代码转换为非文本的二进制数据流。当记事本尝试将这些二进制字节解释为字符时,由于字节值超出有效字符范围或不符合编码规范,就会显示为不可读的符号或乱码。例如,一个经过gzinflate处理的文件,其头部可能包含0x1f 0x8b的gzip魔数,记事本无法将其映射为可读字符,因此呈现乱码。
import binascii

# 模拟一个经过gzip压缩并base64编码的PHP文件内容
original_code = "<?php echo 'Hello World'; ?>"
import gzip
import base64

compressed = gzip.compress(original_code.encode('utf-8'))
encoded = base64.b64encode(compressed).decode('utf-8')

print("Encoded content (first 50 chars):", encoded[:50])
print("Hex dump of original compressed bytes:", binascii.hexlify(compressed).decode())

# 验证:如果直接用记事本打开encoded字符串,它会显示为ASCII可打印字符
# 但如果我们保存的是compressed二进制文件,记事本会显示乱码
with open('encrypted.php', 'wb') as f:
    f.write(compressed)

# 读取二进制文件并显示前10个字节的十六进制
with open('encrypted.php', 'rb') as f:
    header = f.read(10)
    print("File header hex:", binascii.hexlify(header).decode())
运行上述代码后,生成的encrypted.php文件用记事本打开将显示乱码。通过十六进制查看器,可以看到文件头为1f 8b,这是gzip格式的明确标识。这表明文件并非纯文本,而是二进制数据。记事本无法解析这种格式,因此显示乱码。关键在于,加密或编码过程改变了数据的表示形式,使其不再适合文本编辑器直接阅读。
如何识别加密文件的特征
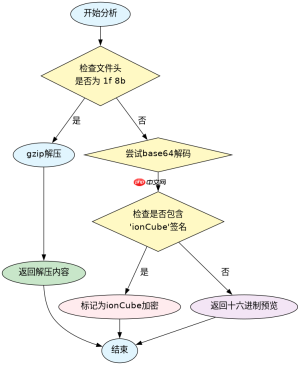
使用支持十六进制查看的编辑器可以揭示加密文件的底层结构。常见的PHP加密工具如Zend Guard、ionCube或自定义脚本,会在文件头部添加特定的魔数或签名。例如,ionCube编码的文件以ionCube字符串开头,而某些自定义编码器可能使用eval(gzinflate(base64_decode(...)))模式,其文件内容可能是base64编码的gzip数据。通过查看十六进制区域,可以识别这些固定模式。此外,一些加密文件可能包含明显的重复结构或特定长度的块,这些特征有助于判断加密算法的类型。

import re
import base64
import gzip
import io

def analyze_encoded_file(filepath):
    with open(filepath, 'rb') as f:
        data = f.read()

    # 检查是否为gzip压缩
    if data[:2] == b'\x1f\x8b':
        try:
            decompressed = gzip.decompress(data)
            return {"type": "gzip_compressed", "content": decompressed.decode('utf-8', errors='ignore')}
        except Exception as e:
            return {"type": "gzip_error", "error": str(e)}

    # 检查是否为base64编码的文本
    try:
        decoded = base64.b64decode(data)
        if decoded[:2] == b'\x1f\x8b':
            decompressed = gzip.decompress(decoded)
            return {"type": "base64_gzip", "content": decompressed.decode('utf-8', errors='ignore')}
        else:
            return {"type": "base64_other", "decoded_preview": decoded[:50]}
    except Exception as e:
        return {"type": "not_base64", "error": str(e)}

    # 检查常见加密签名
    if b'ionCube' in data[:100]:
        return {"type": "ioncube_encrypted"}
    if b'Zend' in data[:100]:
        return {"type": "zend_guard_encrypted"}

    return {"type": "unknown", "hex_preview": data[:50].hex()}

# 示例用法
result = analyze_encoded_file('encrypted.php')
print(result)
该分析脚本展示了如何通过编程方式检测加密特征。对于encrypted.php文件,脚本首先检查gzip魔数,若匹配则尝试解压。如果文件是base64编码的gzip数据,脚本会先解码再解压。此外,脚本还检查ionCube和Zend Guard的常见签名。通过这些步骤,可以准确识别文件的加密类型。例如,如果文件是base64编码的gzip数据,脚本将返回base64_gzip类型,并提供解压后的内容预览。这种方法比手动查看十六进制更高效,且能自动化处理多种加密格式。
基于eval(gzinflate(base64_decode()))模式的解密问题
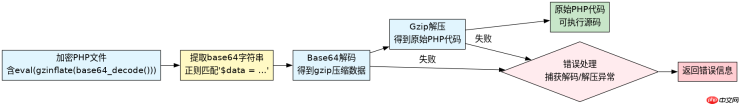
许多PHP加密文件采用eval(gzinflate(base64_decode($data)))模式,其中$data是嵌入在PHP文件中的base64编码的gzip压缩代码。要解密此类文件,需要提取$data变量,进行base64解码和gzip解压,最终得到原始PHP代码。这种模式的特点是文件主体是一个大的字符串常量,包裹在eval()调用中。通过正则表达式或字符串搜索可以找到$data的定义,然后手动或自动执行解码和解压操作。需要注意的是,某些变体可能使用不同的函数名或额外的混淆层,但核心逻辑相同。
import re
import base64
import gzip

def decrypt_eval_gzinflate_php(filepath):
    with open(filepath, 'r', encoding='utf-8', errors='ignore') as f:
        content = f.read()

    # 查找base64编码的数据部分
    # 模式: $data = '...'; 或类似结构
    match = re.search(r'(?:\$[a-zA-Z_][a-zA-Z0-9_]*)\s*=\s*[\'"]([A-Za-z0-9+/=]+)[\'"]', content)
    if not match:
        return None

    encoded_data = match.group(1)
    try:
        decoded = base64.b64decode(encoded_data)
        decompressed = gzip.decompress(decoded)
        return decompressed.decode('utf-8')
    except Exception as e:
        return f"Decryption failed: {str(e)}"

# 示例:假设encrypted.php包含eval(gzinflate(base64_decode('...')))
# 实际文件中,base64字符串可能很长,这里简化处理
sample_content = "<?php eval(gzinflate(base64_decode('H4sIAAAAAAAAA+3BMQEAAADCoPVPbQwfoAAAAAAAAAAAAAAAAAAAAA=='))); ?>"
with open('sample_encrypted.php', 'w') as f:
    f.write(sample_content)

result = decrypt_eval_gzinflate_php('sample_encrypted.php')
print("Decrypted code:", result)
此脚本演示了如何从eval(gzinflate(base64_decode()))模式中解密PHP代码。它首先搜索文件中的base64编码字符串,然后依次进行base64解码和gzip解压。如果成功,将返回原始PHP代码。例如,对于提供的样本文件,脚本将输出。这种方法适用于大多数采用此模式的加密文件。然而,如果加密文件使用了更复杂的混淆或多层编码,可能需要调整正则表达式或增加额外的处理步骤。关键是识别出编码数据的边界,并正确应用解码和解压操作。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





