






使用 docker stats 监控容器资源消耗趋势,最直接的方法是结合 --no-stream 参数进行单次采样,或者通过管道将流式数据重定向到文件。默认情况下该命令会持续刷新终端显示,不适合直接用于长期记录或自动化分析;关闭实时刷新后,你可以获取特定时刻的 cpu、内存和网络 i/o 快照,从而为后续的趋势计算提供基础数据。
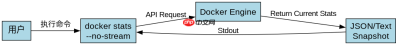
如何获取历史资源数据的快照
要获取历史资源数据的快照,需要禁用 docker stats 的自动刷新功能并指定具体的容器 ID。执行 docker stats --no-stream 命令后,Docker 引擎会返回当前时刻的资源使用情况,包括 CPU 百分比、内存使用量及网络流量。这种单次输出模式允许你将结果保存至文件或变量中,以便在脚本中进行多次采集和对比,进而构建出资源消耗的时间序列趋势。
#!/bin/bash
# 定义容器ID和目标文件
CONTAINER_ID="my_container"
OUTPUT_FILE="/tmp/stats_snapshot.csv"

# 添加CSV表头
echo "timestamp,cpu_percent,memory_usage_mb" > $OUTPUT_FILE

# 循环采集5次数据,每次间隔2秒
for i in {1..5}; do
    # 获取当前时间戳
    TIMESTAMP=$(date +%s)

    # 执行单次统计,解析CPU和内存数据
    # docker stats --no-stream 输出格式固定,需根据实际版本调整awk字段
    STATS=$(docker stats --no-stream --format "{{.CPUPerc}}|{{.MemUsage}}" $CONTAINER_ID)

    CPU=$(echo $STATS | cut -d'|' -f1 | tr -d '%')
    MEM_RAW=$(echo $STATS | cut -d'|' -f2)
    # 简单提取MB数值,假设格式为 "X MiB / Y MiB"
    MEM_USED=$(echo $MEM_RAW | awk '{print $1}')

    echo "$TIMESTAMP,$CPU,$MEM_USED" >> $OUTPUT_FILE

    sleep 2
done

echo "数据采集完成,请查看 $OUTPUT_FILE"
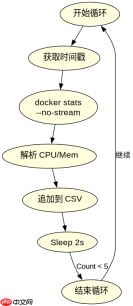
上述脚本演示了如何通过 Bash 循环调用 docker stats --no-stream 来模拟趋势监控。首先初始化一个 CSV 文件用于存储数据,然后在循环中使用 cut 和 awk 从 Docker 的标准输出中提取 CPU 百分比和内存使用量。每次迭代后暂停 2 秒,以捕捉不同时间点的状态。最终生成的文件包含时间戳、CPU 和内存数据,可直接导入 Excel 或 Python Pandas 进行可视化分析。注意,--format 参数依赖于 Docker 版本,确保你的环境支持该格式化选项。
如何将流式数据持久化到日志文件
若需在不中断监控的情况下将数据持久化,可以将 docker stats 的 stdout 直接重定向到日志文件。使用 docker stats 命令,Docker 会将每一帧的统计数据追加写入文件。这种方法适用于需要连续记录资源波动的场景,但需注意文件体积会随时间增长,建议配合日志轮转策略或定期截取片段进行分析。通过解析日志文件中的文本行,可以还原出完整的资源消耗曲线。


# 启动监控并将输出重定向到文件
# 按 Ctrl+C 停止监控
sudo docker stats my_container > /var/log/docker_stats.log 2>&1

# 在另一个终端查看文件内容(部分)
tail -n 20 /var/log/docker_stats.log

# 使用 grep 提取特定容器的数据(如果监控多个容器)
grep "my_container" /var/log/docker_stats.log | head -n 5
此方法利用了 Linux 的重定向机制,将 docker stats 产生的动态文本流保存到磁盘。由于 docker stats 默认每 1-2 秒刷新一次,日志文件会迅速积累大量数据。在实际操作中,建议先测试短时间内的输出格式,确认字段分隔符和数值单位是否符合预期。此外,可以通过 tail -f 实时监控文件更新,或使用 sed 等工具对日志进行实时过滤和清洗,仅保留关键指标。这种方式无需编写复杂脚本,适合快速排查临时性的资源 spike 问题。
基于内存使用量超过阈值的具体问题
当容器内存使用量超过预设阈值时,docker stats 本身不会自动触发告警,但可以通过脚本结合其输出来实现条件判断。例如,在之前的快照脚本中,可以加入 if 语句检查内存值是否大于限制值,一旦超标则发送通知或记录错误日志。这种基于阈值的监控方式能有效防止 OOM(Out of Memory)事件,确保系统稳定性。关键在于正确解析内存字符串并转换为可比对的数值类型。


