






php中截取包含中文的字符串应优先使用 mb_substr,因为它基于字符数而非字节数,能正确处理 utf-8 等多字节编码;若必须使用 substr,则需确保指定正确的起始字节位置和长度,且通常需配合 mb_strlen 计算长度以避免乱码。对于标准的 utf-8 编码文本,mb_substr($str, 0, 2, 'utf-8') 可安全截断前两个汉字,而 substr($str, 0, 6) 在 utf-8 下每个汉字占3字节,故截取6字节等于2个汉字,但此方法对非 utf-8 或混合编码极不稳定。
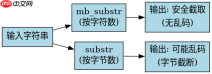
mb_substr 如何按字符数安全截取?
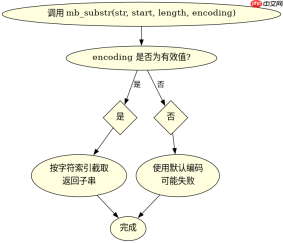
mb_substr 直接接受字符索引和长度参数,自动处理多字节编码,是截取中文的首选方案。它需要启用 mbstring 扩展,并明确指定编码格式(如 'UTF-8'),否则可能因默认编码不同导致错误。该函数返回从起始位置开始、指定长度的子串,若超出范围则返回剩余部分,不会抛出异常,适合大多数 Web 场景。
$str = "你好世界";
echo mb_substr($str, 0, 2, "UTF-8"); // 输出: 你好
上述代码中,$str 为四个汉字的字符串,mb_substr 从索引 0 开始截取 2 个字符,结果为 “你好”。无论输入是否包含英文或数字,只要编码一致,结果均准确。若省略第三个参数 'UTF-8',函数将使用内部默认编码,可能导致意外行为,因此始终显式传入编码值。
substr 为何容易出错及如何补救?
substr 按字节操作,在 UTF-8 编码下每个汉字占 3 字节,因此截取时需手动计算字节偏移,极易因长度非 3 的倍数导致截断半个汉字,产生乱码。补救方法是先用 mb_strlen 获取字符数,再乘以 3 得到字节长度,但此法仅适用于纯 UTF-8 无其他多字节字符的场景,通用性差。

$str = "你好世界";
echo substr($str, 0, 6); // 输出: 你好
// 若截取5字节:
echo substr($str, 0, 5); // 输出: 浣 (乱码)
第一段代码截取 6 字节(2个汉字×3字节),结果正确;第二段截取 5 字节,截断第三个汉字的前两字节,导致 substr 返回无效字节序列,显示为乱码。这证明 substr 不适用于动态或未知长度的中文截取。若坚持使用,必须确保长度是 3 的倍数,且编码固定为 UTF-8,但这限制了其适用性,故不推荐作为常规手段。
当字符串包含 ASCII 字符时截取行为有何差异?
当字符串同时包含中文和 ASCII 字符(如英文字母)时,mb_substr 仍按字符计数,ASCII 字符计为 1 个字符,中文计为 1 个字符,行为一致;而 substr 中 ASCII 占 1 字节,中文占 3 字节,导致字节与字符映射混乱,例如截取 4 字节可能包含 1 个中文(3字节)+1 个英文(1字节),但无法保证完整性。
$mixed = "a你好b";
echo mb_substr($mixed, 0, 3, "UTF-8"); // 输出: a你
// substr 版本:
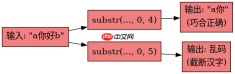
echo substr($mixed, 0, 4); // 输出: a你 (巧合正确,因a=1字节,你=3字节)
echo substr($mixed, 0, 5); // 输出: a你好 (5字节: a+你的前3字节+好的第1字节 → 乱码)
混合字符串示例中,mb_substr 截取前 3 个字符('a', '你', '好' 中的前三个:'a', '你', '好'?更正:$mixed 为 'a','你','好','b',索引0='a',1='你',2='好',3='b',故 mb_substr($mixed,0,3) 返回 'a你',正确)。而 substr 截取 4 字节时,恰好覆盖 'a'(1字节)+'你'(3字节),结果碰巧正确;但截取 5 字节时,覆盖 'a'+'你'+'好' 的第 1 字节,导致 '好' 被截断,产生乱码。这凸显了 substr 在混合内容下的不可靠性,始终建议用 mb_substr 以字符为单位操作,避免字节级陷阱。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!


