






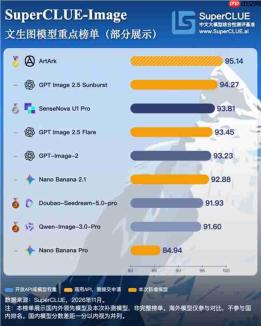
人工智能领域的图像生成赛道再度迎来高光时刻。11月10日,superclue 正式发布了2026年11月的文生图基准更新榜单。本次评测不仅覆盖了海内外主流产品,还首次纳入了国内最新模型 artark 以及 gpt 系列、nano banana 系列等进行补充测评。最终,国产模型 artark 表现突出,以95.14分的综合得分荣登总榜榜首,成功超越 gpt image2.5sunburst。
核心指标震撼业界:图文一致性成为全场唯一满分选手
在这场激烈角逐中,ArtArk 的登顶并非依赖某一项指标的微弱领先,而是展现出卓越的综合语义理解与视觉还原能力。尤其在行业高度关注的“图文一致性”测试维度上,ArtArk 拿下了所有参测模型中的唯一满分。
所谓图文一致性,关键在于检验人工智能对用户文字指令的真实理解深度,以及将多层嵌套的文字描述精准映射为视觉内容的能力。无论是特定人物形象、道具细节,还是多对象的空间关系与动态交互,模型不仅要保障画面审美水准,更需严丝合缝地落实每一条文本约束。ArtArk 获得该项满分,标志着其在复杂语义解析与跨模态对齐能力上已迈入全球第一梯队。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
头部阵营竞争日趋白热化:国产与海外模型差距几近消失
从整体榜单分布来看,全球顶尖文生图模型之间的技术代差已压缩至极限。
在海外模型阵营中,GPT Image2.5Sunburst 以94.27分位居总榜第二,成为海外参测产品中的最高分;同系列的 GPT Image2.5Flare 则以93.45分紧随其后。而在国产模型梯队中,SenseNova U1Pro 取得93.81分,位列国内第二;Doubao-Seedream-5.0-pro 与 Qwen-Image-3.0-Pro 并列国内第三。整体来看,前五名最高分与最低分之间仅相差1.91分,国内外头部产品正处在毫厘之间的高强度拉锯状态。

Qwen 视频智能分析基础客户端(免费版),基于 Qwen 3.5 Plus 多模态模型对本地视频进行内容分析,支持场景描述与基础内容理解,采用默认抽帧频率和提示词,适合快速概览视频,API Key 读取自 ~/.skill-platform/skill-platform.json 的 skills 配置。
各模型差异化优势凸显:功能细分与技术演进持续提速
值得注意的是,尽管总分高度接近,但各主流模型在具体能力维度上呈现出显著的差异化竞争力。
汉字与细节还原能力:GPT Image2.5Sunburst 在汉字生成与现实场景复现两项测试中斩获全场最高分;Flare 则在整体图像质量及图文一致性(93.94分)方面表现优异。
创意与构图能力:GPT-Image-2 在创意生成与逻辑推理项目中得分高达96.81分,其复杂信息布局能力也达到94.04分;而国产模型 SenseNova U1Pro 在复杂信息布局单项中拔得头筹,以95.80分领跑全部参测模型。
系列迭代成效显著:Nano Banana 系列亦实现跨越式进步,其中 Nano Banana2.1 成为该系列当前最高分版本(92.88分),其图文一致性与复杂信息布局能力相较前代分别跃升9.09分和6.87分。
这一轮测评结果清晰表明,当前文生图模型的评估体系早已突破“画面美观”的初级阶段。能否深度解析人类语言意图、高效组织多元素空间逻辑、稳定输出指定文字内容,已成为衡量AI图像生成能力的核心硬性标准。ArtArk 的强势登顶,亦向全球产业界证实:国产文生图模型已具备与国际一线产品全面对标、正面交锋的扎实实力。





