





因为 strlen() 计算的是字符串的原始字节数,而中文在 utf-8 编码下通常占用 3 个字节,所以一个汉字会被算作长度 3。要得到正确的字符数量,应使用 mb_strlen() 并指定 utf-8 编码。
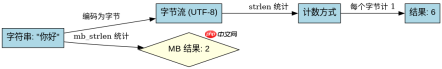
如何获取准确的中文长度
使用 mb_strlen() 函数可以按字符计数。该函数需要两个参数:第一个是目标字符串,第二个是编码格式(通常为 'UTF-8')。它会正确识别多字节字符,返回实际的字符个数而非字节数。
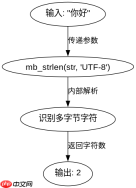
<?php $str = "你好";
$byteLen = strlen($str); // 结果为 6
$charLen = mb_strlen($str, 'UTF-8'); // 结果为 2
echo $byteLen . ", " . $charLen;
?>
为什么不用 iconv 转换后计算
虽然可以通过 iconv 将 UTF-8 转为单字节编码(如 ISO-8859-1)再求长度,但这会导致非拉丁字符丢失或乱码,且代码更复杂。mb_strlen 是专为多字节字符串设计的,直接处理 Unicode 字符,无需转换即可得到准确结果,是更推荐的做法。

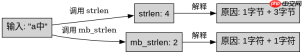
混合中英文时的长度差异
当字符串包含英文和中文时,strlen 会累加英文的 1 字节和中文的 3 字节,而 mb_strlen 统一按字符计数。例如 "a中",strlen 返回 4(1+3),mb_strlen 返回 2(1+1)。这种差异在处理数据库存储、UI 显示截断时需特别注意,避免截断半个汉字。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!


