





在php高并发场景下,直接使用`microtime(true)`获取毫秒时间戳确实存在重复风险,因为多个进程或线程可能在同一微秒内执行。解决这一问题的核心做法是引入一个全局唯一的递增序列号作为“盐”,将其与当前毫秒时间戳组合,从而生成具备时序唯一性的id。具体实现时,应使用redis的原子自增操作(`incr`)来维护这个序列号,确保即使在高并发压力下,每个请求获得的序列号也是严格递增且唯一的,最终将毫秒时间戳与序列号拼接或编码后返回。
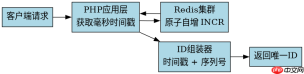
如何设计基于Redis序列号的ID生成结构
要构建可靠的唯一ID,必须明确时间戳部分和序列号部分的占比及组合方式。通常建议保留前13位毫秒时间戳,剩余位数由Redis中的原子计数器填充。这种结构既保留了时间的可排序性,又通过分布式计数器解决了并发冲突。在实际代码中,需要定义一个固定的Redis Key用于存储序列号,并设置合理的过期策略或回滚机制,防止计数器无限增长导致溢出。
$redis = new Redis();
$redis->connect('127.0.0.1', 6379);

function generateUniqueId(Redis $redis) {
    // 1. 获取当前毫秒时间戳
    $timestamp = floor(microtime(true) * 1000);

    // 2. 获取原子递增的序列号
    // 假设每个毫秒周期内最多允许1000个请求,超过则等待下一毫秒
    $sequence = $redis->incr('id_sequence');
    if ($sequence >= 1000) {
        // 简单处理:如果序列号超限,等待下一毫秒并重试
        usleep(1000);
        return generateUniqueId($redis);
    }

    // 3. 组合生成唯一ID
    // 这里简单拼接,实际生产环境建议使用Snowflake算法或UUIDv7
    $uniqueId = $timestamp . str_pad($sequence, 4, '0', STR_PAD_LEFT);

    return $uniqueId;
}

echo generateUniqueId($redis); // 输出示例: 17156234567890001
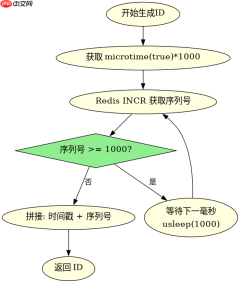
上述代码展示了最基础的加盐逻辑。首先调用`microtime(true)`乘以1000并向下取整得到毫秒级时间戳。接着通过`$redis->incr()`获取一个全局唯一的序列号。为了防止单毫秒内并发量超过序列号容量(示例中设为1000),加入了简单的重试逻辑。最后将两者拼接成字符串ID。这种方式保证了在同一毫秒内,不同请求获得的ID因序列号不同而唯一。
如何处理高并发下的序列号溢出与性能瓶颈
当系统并发量极大时,单一的Redis Key可能成为性能瓶颈,或者序列号在极短时间内耗尽。此时需要优化序列号的分配策略,例如采用分段预分配或多Key轮询。同时,必须考虑时钟回拨问题,虽然PHP本身不直接处理NTP同步,但应用层需确保服务器时间准确。若出现序列号溢出,除了等待下一毫秒,还可以结合机器ID或随机数进行补偿,确保ID的全局唯一性而不只是局部唯一。

// 优化版:支持多节点预分配序列号范围
$redis = new Redis();
$redis->connect('127.0.0.1', 6379);

// 假设机器ID为1
$machineId = 1;
$prefix = "seq_machine_{$machineId}_";

function generateOptimizedUniqueId(Redis $redis, int $machineId) {
    $key = "seq_machine_{$machineId}";

    // 尝试获取当前毫秒的序列号
    $now = floor(microtime(true) * 1000);
    $cacheKey = "{$key}:{$now}";

    $seq = $redis->get($cacheKey);
    if ($seq === false || $seq === null) {
        // 初始化该毫秒的计数器
        $redis->setex($cacheKey, 2, 0); // 设置2秒过期,清理旧数据
        $seq = 0;
    } else {
        $seq = (int)$seq;
    }

    if ($seq >= 10000) {
        // 序列号耗尽,等待下一毫秒
        while (floor(microtime(true) * 1000) == $now) {
            usleep(100);
        }
        return generateOptimizedUniqueId($redis, $machineId);
    }

    $redis->incr($cacheKey);

    // 组合:时间戳 + 机器ID + 序列号
    return sprintf("%d_%d_%05d", $now, $machineId, $seq);
}

echo generateOptimizedUniqueId($redis, 1); // 输出示例: 1715623456789_1_00001
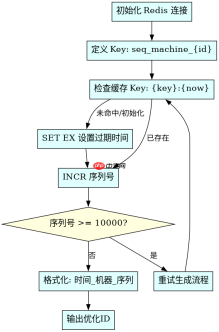
优化后的代码引入了机器ID和前缀Key的概念,使得不同节点的序列号空间隔离,减少竞争。使用`setex`命令为每个毫秒周期的序列号设置短过期时间,自动清理历史数据,避免Redis内存膨胀。当检测到序列号达到上限(10000)时,程序会阻塞等待直到进入下一个毫秒周期,从而保证生成的ID始终唯一且有序。这种设计更适合大规模分布式部署。
基于程序中某个输入、条件或结果的具体问题
在上述代码中,如果Redis连接断开或`incr`操作失败,会导致ID生成中断或返回错误值。这是一个具体的运行时条件问题。解决方法是在调用Redis操作前后增加异常捕获和降级策略。例如,当Redis不可用时,可以临时切换回本地内存计数器或生成纯随机UUID,虽然牺牲了部分时序性,但保证了系统的可用性。此外,还需监控Redis的健康状态,确保在高并发下主从复制延迟不会导致序列号重复。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





