





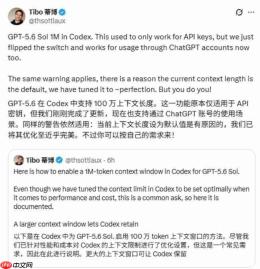
openai 负责 codex 与 chatgpt 的工程师 tibo 近日在 x 平台透露,codex 中搭载的 gpt-5.6 sol 模型已正式向 chatgpt 订阅用户开放 100 万 token 的超长上下文窗口能力——此前该功能仅限 api 密钥调用。这一变化意味着长期困扰订阅用户的“历史被迫截断”问题,终于迎来实质性突破。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
订阅用户可自主启用百万级上下文
Tibo 明确表示,GPT-5.6 Sol 在 Codex 中原生支持长达 100 万 Token 的上下文长度,而这项能力现已“刚刚解锁”,全面覆盖 ChatGPT 账号体系。Plus、Pro 等付费订阅用户,在使用 Codex 编程代理时,可通过手动设置激活最高约 105 万 Token 的完整上下文容量。
更宽裕的上下文空间显著提升了 Codex 对代码片段、工具执行结果及多轮对话内容的留存能力,尤其适用于大型代码库迁移、深度链路调试、跨会话持续开发等高要求工程场景。对于维护企业级或开源核心仓库的开发者来说,这直接缓解了过去频繁遭遇“上下文溢出”的核心瓶颈。

默认值经过权衡,开启前请评估实际需求
Tibo 特别指出,Codex 当前预设的上下文长度是基于响应速度、推理稳定性与资源开销三者深度优化后的结果,并非随意设定;他建议用户“根据自身需要自行判断是否启用”。不少一线开发者也证实,依托 Codex 内置的服务端智能压缩策略,当前默认配置在绝大多数常规编程任务中依然保持高效且稳定。
但亦有用户反馈,一旦启用百万级上下文,账户周额度消耗速率明显加快,单次复杂任务就可能占用大量配额。因此建议仅在处理真正需要超长记忆的项目时临时开启,避免将其设为日常默认选项,以防关键开发阶段提前耗尽可用额度。


