





这或许是 amd 等待已久的转折点。
近期,Wafer AI 成功在 AMD MI355X 上部署了 Kimi K3 大模型。令人瞩目的结果是:原本需依赖 16 张 NVIDIA B200、分散于两台服务器才能运行的模型,如今仅用一台搭载 8 张 MI355X 的 AMD 服务器即可完成部署。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
更值得强调的是,这并非简单“塞进去”——而是真正实现了高效推理。
在输入长度为 1024 Token、输出长度为 400 Token 的标准测试中,MI355X 实现了高达 952 Token/s 的总吞吐量,单用户生成速度达 118 Token/s。
按单节点计算,其吞吐能力约为 16 卡 B200 双节点方案的 3.8 倍;在单位成本效率上,也已超越 B200 和 B300。
最出人意料的一点在于:ROCm 这次几乎没有“掉链子”。
当模型膨胀到极致,显存比算力更关键
Kimi K3 拥有 2.8 万亿参数,仅模型权重就需占用超 1.5 TB 显存,尚未计入支撑百万级上下文所需的 KV Cache。
一台配备 8 张 B200 的服务器,单卡显存为 192 GB,合计约 1.5 TB——刚好勉强容纳模型权重,几乎无法为 KV Cache 预留空间。因此,B200 不得不采用双机 16 卡架构。
而 B300 单卡显存提升至 288 GB,可在单节点内完整加载模型。巧合的是,AMD MI355X 同样配备了 288 GB 显存,8 卡总计约 2.3 TB,足以将整个模型与 KV Cache 全部置于同一节点。
这不只是节省了一台物理服务器的问题。一旦模型跨节点部署,每个 Token 的生成都可能涉及节点间通信。即便使用带宽高达 195 Gb/s 的 RoCE v2 网络,这种跨节点同步仍会显著拖慢解码节奏。
MI355X 凭借更大的显存容量,将全部计算逻辑收敛于单一节点之内。
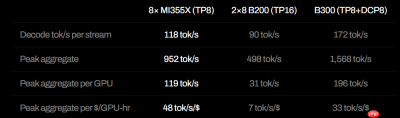
最终实测数据显示:8 张 MI355X 达成峰值总吞吐 952 Token/s,单路生成速率为 118 Token/s。
作为对照,16 张 B200 双节点部署总吞吐为 498 Token/s,折算为单节点平均值约为 249 Token/s。
换言之,MI355X 单节点吞吐约为 B200 双节点平均单节点吞吐的 3.8 倍;单用户生成速率方面,MI355X 的 118 Token/s 亦高于 B200 的 90 Token/s。
B300 当前仍是性能天花板。8 卡 B300 节点总吞吐达 1568 Token/s,单路生成速率为 172 Token/s,整体吞吐约为 MI355X 的 1.65 倍。
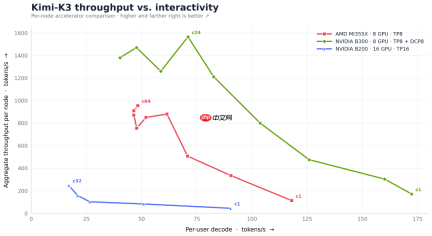
但价格改变了胜负天平。Wafer 以 MI355X 每卡每小时 2.5 美元、B200 为 4.25 美元、B300 为 6 美元为基准进行测算:
在此假设下,MI355X 每美元可提供约 48 Token/s 的峰值吞吐;B200 约为 7 Token/s;B300 约为 33 Token/s。
B300 更快,但 MI355X 的单位成本产出更高。对于大规模部署开源大模型的数据中心而言,这或许比单纯追求峰值性能更具现实意义。
更惊喜的是,ROCm 居然基本开箱即用
长久以来,AMD 数据中心 GPU 的核心瓶颈往往不在硬件本身,而在软件生态。
同一模型在 CUDA 平台上可直接运行,切换至 ROCm 后却常面临框架适配、算子缺失,甚至需重写底层内核等难题。
但 Kimi K3 的部署过程打破了这一惯性。
AMD 为其提供了近乎同步的首发支持。Wafer 表示,模型主体几乎无需修改即可在 MI355X 上启动,后续工作主要集中于少量兼容性修复与性能调优。
其中一处问题出现在推测解码环节。Kimi K3 并未内置 MTP 或 EAGLE 所需的草稿模型参数,Wafer 因此引入了一个外部块扩散草稿模型。

一键设置,在 OpenClaw 和 Claude Code CLI 中使用 Kimi K2.5 (Kimi Code) 作为编程模型。Kimi Code 兼容 Anthropic Messages API——替换……
该方案在 CUDA 环境下运行无误,但在 ROCm 中,首个真实请求即触发调度器报错——原因在于 ROCm 分支中遗漏定义了一个名为 top_k_renorm_prob 的函数。
该函数功能极为简洁:从概率分布中选取 top-k 值,将其余概率置零,并对保留值重新归一化。
Wafer 最终仅用一个标准 PyTorch 函数补全逻辑,既无需手写 GPU 内核,也不必重构推测解码流程。
修复完成后,推测解码使单路性能提升约 2.2 倍,中等并发下单流性能提升约 1.7 倍,峰值总吞吐量亦增长约 18%。
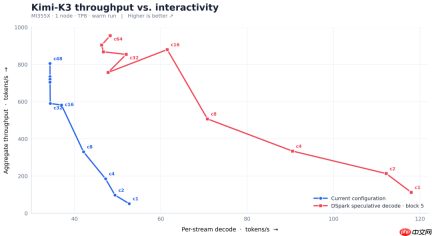
更重要的是,系统能在更高并发水平下稳定达到峰值吞吐。
首字延迟高?只加了四个零就搞定
当然,吞吐量并非推理服务的全部。对终端用户而言,TTFT(Time To First Token)——即从请求发出到首个 Token 返回的时间——同样至关重要。
在这方面,MI355X 初期表现并不理想。面对一段约 17.2 万 Token 的冷启动预填充任务,MI355X 耗时约 51 秒,而 B300 仅需约 23 秒。
在支持百万级上下文的大模型场景中,预填充任务规模庞大。若每次长上下文交互都需等待数十秒才见首字,再高的解码速度也难以挽回用户体验。
Wafer 最终定位到瓶颈根源:一个注意力内核。Kimi K3 在 8 路张量并行配置下,每张 GPU 分配 12 个注意力头;而 AMD AITER 中优化程度最高的 MLA 预填充内核,仅支持 4、8 或 16 等整数倍形状。
12 无法匹配,系统被迫回退至较慢的通用 Triton 实现。
解决方案极其朴素:将 12 个注意力头补零至 16,调用现有高速内核完成计算,再截取前 12 个有效结果。既未改动模型结构,也未新增汇编代码,只是添了四个零。
优化后,AITER MLA 内核稳定预填充速度达约 1.3 万 Token/s,相较原 Triton 回退路径(约 4000~7000 Token/s)提速两到三倍,冷预填充时间大幅压缩。
此项优化虽不影响最终解码吞吐,却显著缩短了用户等待首个 Token 的时间。
这也揭示了一个事实:AMD 与 NVIDIA 之间看似巨大的软件鸿沟,有时并非源于底层能力缺失,而只是当前高速内核尚未覆盖某些新兴模型结构。
CUDA 的护城河仍在,但裂缝已然显现
单次测试自然不足以宣告 AMD 全面赶超 NVIDIA。
B200 因显存限制被迫跨节点部署;B300 的绝对性能依旧领先;ROCm 的工具链成熟度、框架兼容性及开发者生态,目前仍逊于 CUDA。
但开源大模型正加速迈入万亿参数时代。当模型体积突破单机承载极限时,显存容量便不再只是规格表上的冰冷数字,而是直接影响通信开销、部署复杂度与实际吞吐的关键变量。
AMD 为单卡配备更大容量 HBM 的策略,正在转化为真实的系统级优势。
倘若 AMD 能持续提升 ROCm 的稳定性、拓展高速内核对各类模型结构的支持广度,并为新模型提供更快响应的首日适配能力,那么数据中心决策者将不得不重新评估这些 GPU 的价值:价格更低、显存更大、性能达标,且软件不再需要耗费数月调试。
对此你怎么看?
参考链接:
https://www.php.cn/link/f4be5653ef44afffe060ac4a06f0969e
https://www.php.cn/link/267aa80d7d7cd3a093da2f3858e003ec
本文来自微信公众号 “机器之心”(ID:almosthuman2014),作者:关注LLM的,36氪经授权发布。





