【php中文网资讯】8月5日,字节跳动seed官方宣布,全新原生音视频全双工大模型——seedrealtime正式对外发布。该模型的最大创新在于将语音、图像、时间序列及语义表达深度融合于同一端到端架构之中,彻底打破传统模型“先接收、再处理、后响应”的串行范式,真正实现感知、理解、决策与生成的并行协同。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
 据悉,SeedRealtime标志着全模态交互技术迈入实质性落地阶段,为行业首次实现音视频全双工能力的大规模应用。其基于统一模型底座,原生整合音频、视频与文本三类模态,在持续流动的多模态信息流中完成毫秒级实时交互,带来“边看、边听、边说”三位一体的自然对话体验。当前,该模型已在豆包App全面部署并上线运行。
SeedRealtime在以下三大维度取得关键进展:多模态音视频联合建模、具备主动意图识别的交互能力、以及高度拟人化的节奏控制能力。

大模型Token成本节约
下载
大模型 Token 成本节约工具。在请求到达大模型之前自动压缩 prompt 和上下文,减少 60-95% 的 token 消耗,直接降低 API 成本。支持 Claude/OpenAI/Gemini 等主流模型,提供代理模式、CLI 包装、Python SDK 和 MCP Server 四种接入方式。内置一键安...
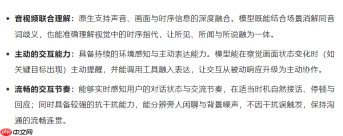 端到端人工评估结果显示,相较于传统级联式多模态方案,SeedRealtime显著缓解对话节奏不自然问题,相关异常率下降达50%;有效减少插话干扰、响应滞后、环境噪音误唤醒等典型交互卡顿现象,单轮完整、连贯对话的成功率显著提高。