





在长程 agent与编程任务中,如何提高强化学习(rl)的训练效率,依然是当前研究的关键挑战。
当前主流的大语言模型强化学习(LLM RL)流程普遍采用同步、批量式架构,必须等待整批 rollout 全部生成完毕后才能进行参数更新,导致训练吞吐受限。尽管异步 RL可在一定程度上缓解同步阻塞问题,但现有方案多聚焦于系统吞吐量提升,对训练稳定性与任务性能兼顾不足;此外,GRPO 方法依赖于成组采样机制,在异步 Agent 场景下难以直接复用。
为应对这一瓶颈,清华大学KEG实验室提出了一种新型训练范式——单 rollout 异步优化(Single-rollout Asynchronous Optimization,SAO)。该方法摒弃 GRPO 的组式采样策略,转而为每个输入任务仅生成一条可即时投入训练的rollout,显著削弱离策略偏差,并增强策略泛化能力。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文链接:https://www.php.cn/link/12f1d09a4ef2f02622bfbd6cb2b31dc7
实验表明,SAO 能够稳定训练至 1000 步,在Agent 编程任务与数学推理基准上持续超越 GRPO 及其改进版本;同时,单 rollout RL 在模拟在线学习场景中亦展现出对动态奖励分布的良好适应性。
该技术已集成进GLM-5.2(750B-A40B)的Agent RL 训练流水线中。
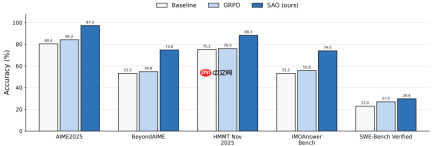
图|SAO 在推理与代码类基准上的性能表现。
SAO 如何保障异步训练稳定性?
SAO 整体采用单 rollout 异步优化框架:每个任务仅生成一条 rollout,完成后即刻参与训练。为确保流程鲁棒运行,SAO 引入了直接双边重要性采样(DIS)、高频价值模型更新、多轮轨迹优势过滤机制,并扩大价值模型预训练数据覆盖范围。具体设计如下:
1. 直接双边重要性采样(DIS):用于抑制异步训练中的离策略误差。由于 rollout 生成与策略更新存在时间差,SAO 不依赖历史策略快照,而是直接利用 rollout 阶段记录的 token 级对数概率计算重要性权重,对超出阈值范围的 token 梯度予以屏蔽,避免异常更新干扰训练。
2. 提升价值模型更新频次:用于缓解单 rollout 下梯度估计高方差问题。单样本 rollout 导致优势信号噪声增大,因此 SAO 将策略模型与价值模型更新解耦:每执行一次策略更新,同步完成两次价值模型更新,从而提升优势估计精度,降低整体训练波动。
3. 冻结注意力模块参数:用于稳定价值模型收敛过程。实验发现,价值模型不稳定性主要源于全注意力层参数更新,而混合专家层(MoE)相对稳健。因此 SAO 在价值模型训练阶段固定注意力模块参数,仅微调 MoE 投影层,有效抑制价值函数震荡。
4. 观察 token 跳过的 GAE 计算:用于削弱多轮 Agent 轨迹中环境反馈引入的噪声。在交互式多轮任务中,模型动作与环境观测交替出现;若将观测 token 直接纳入优势计算,会污染信号传播路径。SAO 显式跳过所有环境反馈 token,仅在模型自主生成的动作序列间传递优势信息。
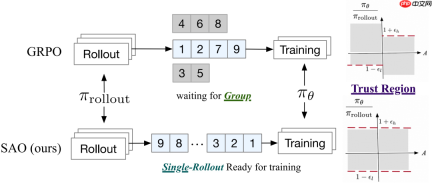
图|集成单 rollout 架构的 SAO 总体框架示意图。
SAO 的实证效果如何?
实验验证显示,SAO 在数学推理、代码生成与修复及模拟在线学习任务中均取得更优性能;在多个权威基准上全面超越基线模型与 GRPO 系列方法,并在整个训练周期内保持良好收敛性。关键结果如下:
数学推理与代码任务表现
SAO 测试涵盖支持 Python 工具调用的奥赛级数学推理、复杂数学问答以及真实世界代码修复等典型场景。结果显示,SAO 在各项任务中均优于对应基线及 GRPO 变体。在 AIME2025 基准上,SAO 达到 97.3% 准确率,显著高于 GRPO 的 84.2%。
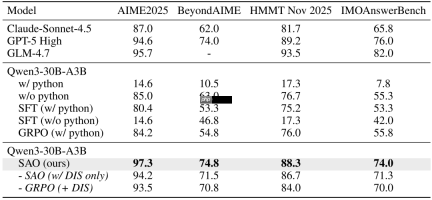
图|数学推理任务上的准确率对比(%)。
在代码任务SWE-Bench Verified 上,SAO 实现 29.8% 解决率,优于基线模型的 23.0% 和 GRPO(w/ DIS)的 27.0%。
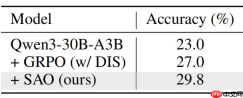
图|SWE-Bench Verified 基准测试结果。
训练稳定性分析
从训练曲线可见,SAO 在各基准上始终维持领先优势,且训练过程更为平滑。标准 GRPO 在早期即出现性能塌陷;引入 DIS 后虽可延缓崩溃,但仍难持续提升;而 SAO 不仅全程稳定,还在中后期持续拉升评估指标。

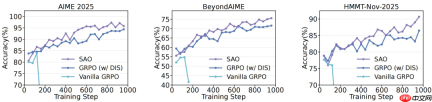
图|SAO 与 GRPO(w/ DIS)训练过程性能对比。
训练动态演化
实验进一步揭示,SAO 的稳定性源于其模块化协同设计:更频繁的价值模型更新使优势估计更贴近真实回报;冻结注意力参数显著改善价值函数学习平稳性;DIS 则通过裁剪极端重要性权重控制策略漂移。作为对照,未使用 DIS 的 VAPO 方法在约 90 步即发生训练崩溃。
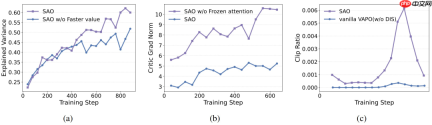
图|异步单 rollout RL 的训练动态演化过程。
消融实验验证
研究团队对 SAO 各核心组件开展系统性消融分析,包括降低价值模型更新频率、启用全参数价值模型训练、替换为无 DIS 的 VAPO 对照,以及引入滑动平均基线。结果一致表明,完整 SAO 架构性能最优;在 BeyondAIME 基准上,完整版 SAO 达 74.8% 准确率,移除高频价值更新后下降至 69.8%。
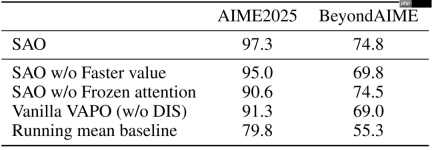
图|价值模型训练策略与 critic 更新频率的消融结果。
在线学习模拟表现
团队构建风格切换写作任务以检验 SAO 在非平稳环境下的在线适应能力。任务中奖励偏好按周期在可爱风、中二风与古典风之间切换。SAO 能在风格变更后快速对齐新目标,并维持更高训练奖励水平;而滑动平均基线则表现出明显响应延迟与更低收敛上限。
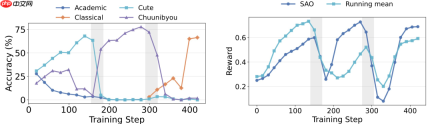
图|不同写作风格偏好切换下的在线学习模拟效果。
局限性与后续方向
尽管 SAO 在多种 Agent 任务中展现出优异稳定性,研究者也指出其仍面临适用边界、工程部署与实际落地三方面挑战:
1. 扩展性验证待加强
当前实验集中于基于 Qwen3-30B-A3B 的大规模 Agent 推理、代码任务及模拟写作任务。未来需进一步验证 SAO 是否适配轻量化模型、非 Agent 类 RLHF 场景,以及高密度奖励、短序列 rollout等多样化任务设定。
2. 部署基础设施需完善
SAO 依赖高质量价值模型输出与精确保存的rollout token 对数概率。若要在生产环境中落地,需配套建设可靠的异步 rollout 日志系统,确保关键中间状态可追溯、可复用。
3. 真实在线适应的安全机制待健全
当前在线学习实验仅限可控仿真环境。面向真实用户场景部署时,还需构建更强健的安全防护体系、实时行为监控模块及用户数据隐私审查流程。
4. 发布与治理机制亟需强化
研究者强调,若缺乏严格的数据清洗管道、访问权限管控与多维评估闭环,SAO 所赋能的能力可能被导向有害目标。因此,基于 SAO 的系统发布必须遵循负责任 AI 原则,并建立长期运行监控机制。
更多技术细节请参阅原文。
本文来自微信公众号“学术头条”(ID:SciTouTiao),作者:夏千斯,36氪经授权发布。


