





运行平台: windows python版本: python3.6 ide: sublime text 其他工具: chrome浏览器
0、写在前面的话
本文是基于基础版上做的修改,如果没有阅读基础版,请移步 Python爬虫之五:抓取智联招聘基础版
在基础版中,构造url时使用了urllib库的urlencode函数:
代码语言:javascript代码运行次数:0运行复制

Git post-commit 钩子 + SQLite 提交索引工具。自动将每次提交的元数据(哈希值、作者、分支、仓库、主题)记录到本地 SQLite 数据库中,随后提供一个命令行接口(CLI),支持查询、列表展示、统计、删除和更新记录。 触发场景:管理 Git 钩子、跨仓库查询提交历史、定位某次提交所属的仓库、查看提交统计信息、将提交记录写入本地索引。 当用户提及“提交日志记录”、“提交索引”、“跨仓库查找提交”、“Git 钩子管理”,或希望以结构化方式查询其提交历史时(即使未明确指出该工具),请使
url = 'https://sou.zhaopin.com/jobs/searchresult.ashx?' + urlencode(paras) try: # 获取网页内容,返回html数据 response = requests.get(url, headers=headers) ...
其实用reuqests库可以完成此工作,本例将该部分改为:
代码语言:javascript代码运行次数:0运行复制
url = 'https://sou.zhaopin.com/jobs/searchresult.ashx?' try: # 获取网页内容,返回html数据 response = requests.get(url, params=paras, headers=headers) ...
1、找到职位链接
为了得到更加详细的职位信息,我们要找到职位链接,在新的页面中寻找数据。上篇文章中我们没有解析职位链接,那再来找一下吧:
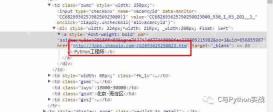
修改一下正则表达式:
代码语言:javascript代码运行次数:0运行复制
# 正则表达式进行解析 pattern = re.compile('<td class="zwmc" . target="_blank">(.*?).*?' # 匹配职位详情地址和职位名称 '</td><td class="gsmc">.*? target="_blank">(.*?).*?' # 匹配公司名称 '</td><td class="zwyx">(.*?)</td>', re.S) # 匹配月薪 # 匹配所有符合条件的内容 items = re.findall(pattern, html)
2、求工资平均值
工资有两种形式xxxx-yyyy或者面议,此处取第一种形式的平均值作为分析标准,虽有偏差但是也差不多,这是求职中最重要的一项指标。
代码语言:javascript代码运行次数:0运行复制
for item in items: salary_avarage = 0 temp = item[3] if temp != '面议': idx = temp.find('-') # 求平均工资 salary_avarage = (int(temp[0:idx]) + int(temp[idx+1:]))//2
3、解析职位详细信息3.1 网页解析
第一步已经将职位地址找到,在浏览器打开之后我们要找到如下几项数据:
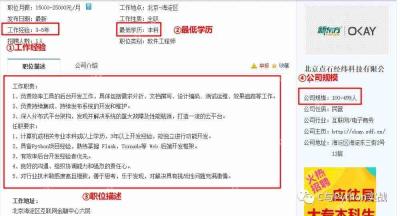
在开发者工具中查找这几项数据,如下图所示:
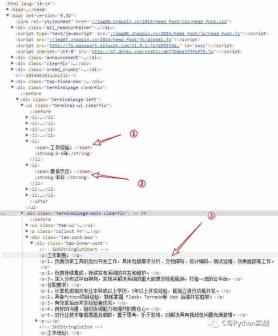
HTML结构如下所示:
代码语言:javascript代码运行次数:0运行复制
pip install beautifulsoup4
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!





