







互联网营销服务公司网站HTML5模板是一款提供网络营销、市场战略、数字营销等服务公司宣传网站模板下载。提示:本模板调用到谷歌字体库,可能会出现页面打开比较缓慢。
段落排序是信息检索领域中十分重要且具有挑战性的话题,受到了学术界和工业界的广泛关注。段落排序模型的有效性能够提高搜索引擎用户的满意度并且对问答系统、阅读理解等信息检索相关应用有所助益。在这一背景下,例如 MS-MARCO,DuReader_retrieval 等一些基准数据集被构建用于支持段落排序的相关研究工作。然而常用的数据集大部分都关注英文场景,对于中文场景,已有的数据集在数据规模、细粒度的用户标注和假负例问题的解决上存在局限性。在这一背景下,我们基于真实搜索日志,构建了一个全新的中文段落排序基准数据集:T2Ranking。
T2Ranking由超过 30 万的真实查询和 200 万的互联网段落构成,并且包含了由专业标注人员提供的 4 级细粒度相关性标注。目前数据和一些 baseline 模型已经公布在 Github,相关研究工作已作为 Resource 论文被 SIGIR 2023 录用。
- 论文信息:Xiaohui Xie, Qian Dong, Bingning Wang, Feiyang Lv, Ting Yao, Weinan Gan, Zhijing Wu, Xiangsheng Li, Haitao Li, Yiqun Liu, and Jin Ma. T2Ranking: A large-scale Chinese Benchmark . SIGIR 2023.
- 论文地址:https://arxiv.org/abs/2304.03679
- Github 地址:https://github.com/THUIR/T2Ranking
背景与相关工作
段落排序任务的目标是基于给定的查询词,从一个大规模段落集合中召回并排序候选段落,按照相关性从高到低的顺序得到段落列表。段落排序一般由段落召回和段落重排序两个阶段组成。
为了支持段落排序任务,多个数据集合被构建用于训练和测试段落排序算法。广泛使用的数据集大多聚焦英文场景,例如最常用的有 MS-MARCO 数据集,该数据集包含了 50 多万个查询词和 800 多万个段落,其中,每一个查询词都具有问题属性。对于每一个查询词,MS-MARCO 数据发布团队招募了标注人员提供了标准答案,根据给定段落是否包含人工提供的标准答案判断这个段落是否与查询词相关。
在中文场景中,也有一些数据集被构建用于支持段落排序任务。例如 mMarco-Chinese 是 MS-MARCO 数据集的中文翻译版本,DuReader_retrieval 数据集采用了和 MS-MARCO 相同的范式生成段落标签,即从人工提供的标准答案中来给定查询词 - 段落对的相关性评分。Multi-CPR 模型包含了来自三个不同领域(电子商务、娱乐视频和医药)的段落检索数据。基于搜狗搜索的日志数据,Sogou-SRR,Sogou-QCL 和 Tiangong-PDR 等数据集也相继被提出。
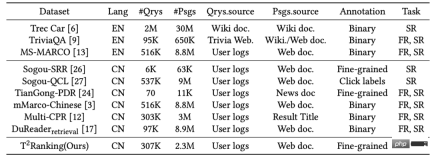
图 1:段落排序任务中常用数据集的统计信息
虽然已有数据集推进了段落排序应用的发展,我们也需要关注几个局限性:
1)这些数据集不是大规模的或者相关性标签不是人工标注的,特别是在中文场景下。Sogou-SRR 和 Tiangong-PDR 仅包含了少量的查询数据。虽然 mMarco-Chinese 和 Sogou-QCL 规模较大,但前者基于机器翻译,后者采用的相关性标签为用户的点击数据。最近,Multi-CPR 和 DuReader_retrieval 两个规模相对较大的数据集被相继构建和发布。
2)已有数据集缺乏细粒度的相关性标注信息。大部分数据集采用了二值相关性标注(粗粒度),即相关或者不相关。已有工作表明细粒度的相关性标注信息有助于挖掘不同实体之间的关系和构建更加精准的排序算法。然后已有数据集不提供或者仅提供少量的多级细粒度标注。例如 Sogou-SRR 或者 Tiangong-PDR 仅提供不超过 10 万个的细粒度标注。
3)假负例问题影响了评价的准确性。已有数据集受到了假负例问题的影响,即有大量相关文档被标记为不相关文档。这一问题是由于大规模数据中人工标注数量过少引起的,会显著影响评价的准确性。例如在 Multi-CPR 中,对于每一个查询词只有一个段落会被标记为相关,而其他都会被标记为不相关。DuReader_retrieval 尝试让标注者人工检查并且重新标注靠前的段落集合来缓解假负例问题。
为了能够更好地支持段落排序模型进行高质量的训练和评测,我们构建并且发布了一个新的中文段落检索基准数据集 - T2Ranking。
数据集构建流程
数据集的构建流程包括查询词采样,文档召回,段落提取和细粒度相关性标注。同时我们也设计了多个方法用于提升数据集质量,包括采用基于模型的段落切分方法和基于聚类的段落去重方法保证了段落的语义完整性和多样性,采用基于主动学习的标注方法提升标注的效率和质量等。
1)整体流程
- 查询词采样:我们从搜狗搜索引擎的搜索日志中采样了真实用户提交的查询词,经过去重和归一化处理后得到了初始查询词集合。接着,我们使用意图分析算法去除了色情查询,非疑问查询,资源申请类查询和可能包含用户信息的查询,保证最终查询数据集合仅包含高质量、具有问题属性的查询。
- 文档召回:基于采样得到的查询词,我们从搜狗、百度和谷歌等多个主流搜索引擎召回了文档候选集合,充分综合了这些搜索引擎在索引和排序文档方面的能力。因为这些搜索引擎能够覆盖互联网数据的不同部分并且能够返回多样化的文档结果,因此能够提高文档候选集合的完整性,并且在一定程度上缓解假负例问题。
- 段落提取:段落提取步骤涉及到段落分割和去重。不同于采用启发式方法在文档中分割段落(例如常规地通过换行符确定段落的开始和结束),我们训练了段落语义模型来进行段落分割,尽可能地保证每个段落的语义完整性。此外,我们还引入了一种基于聚类的技术来提高标注的效率并且保证了标注段落的多样性,这个技术能够有效地移除高度相似的段落。
- 细粒度相关性标注:所聘请的标注人员均为搜索相关标注任务的专家,并且长期从事标注工作。对于每一个查询词 - 段落对,至少 3 名标注人员会提供标注。如果 3 名标注人员的标注结果均不一致,我们会引入额外的标注者进行标注,如果 4 名标注者的结果均不一致,我们倾向于认为这个查询词 - 段落对太过于模糊,质量较低且不太能够确定所需要的信息,从而将该查询词 - 段落对排除在数据集外。我们通过多数投票的方式来确定最终的相关性标签。我们采用的 4 级相关性标注指南与 TREC 基准一致。
- 级别 0:查询词与段落内容之间完全不相关
- 级别 1:段落内容与查询词相关,但不符合查询词的信息需求
- 级别 2:段落内容与查询词相关,能够部分满足查询词的信息需求
- 级别 3:段落内容能够完全满足查询词的信息需求,并且包含了准确答案。
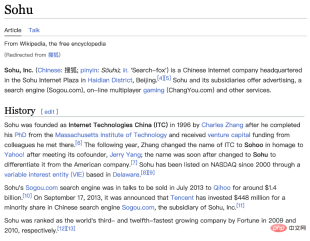
图 2:维基百科页面示例。所展示的文档包含了清晰定义的段落。
2)基于模型的段落分割方法
在现有数据集中,段落通常是根据自然段落(换行符)或通过固定长度的滑动窗口从文档中进行分割得到的。然而,这两种方法可能都会导致段落的语义不完整或者因为段落过长而导致段落包含了多个不同的主题。在这个工作中,我们采用了基于模型的段落分割方法,具体而言,我们使用搜狗百科、百度百科和中文维基百科作为训练数据,因为这部分文档的结构是比较清晰的,并且自然段落也都得到了较好的定义。我们训练了一个分割模型来判断一个给定的单词是否需要作为分割点。我们利用了序列标注任务的思想,将每一个自然段的最后一个单词作为正例对模型进行训练。
3)基于聚类的段落去重方法
对高度相似的段落进行标注是冗余和无意义的,对于段落排序模型而言,高度相似的段落内容带来的信息增益有限,因此我们设计了一个基于聚类的段落去重方法来提高标注的效率。具体而言,我们采用了一个层次化聚类算法 Ward 对相似文档进行无监督聚类。在同一个类中的段落被认为是高度相似的,我们从每一个类中采样一个段落进行相关性标注。需要注意的是,我们只在训练集中进行这个操作,对于测试集,我们会对所有提取的段落进行完整标注,减少假负例的影响。
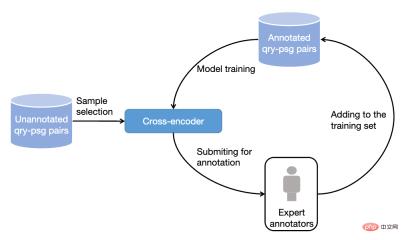
图 3:基于主动学习的采样标注流程
4)基于主动学习的数据采样标注方法
在实践中,我们观察到并不是所有的训练样本都能够进一步提升排序模型的性能。对于模型能够准确预测的训练样本,对于后续模型的训练助益有限。因此,我们借鉴了主动学习的想法,让模型能够选择更有信息量的训练样本进行进一步的标注。具体而言,我们先基于已有的训练数据,训练了一个以交叉编码器为框架的查询词 - 段落重排序模型,接着我们用这个模型对其他数据进行预测,去除过高置信分数(信息量低)和过低置信分数(噪音数据)的段落,对保留的段落进行进一步标注,并迭代这一流程。
数据集统计信息
T2Ranking 由超过 30 万的真实查询和 200 万的互联网段落构成。其中,训练集包含约 25 万个查询词,测试集包含约 5 万个查询词。查询词长度最长为 40 个字符,平均长度在 11 个字符左右。同时,数据集中的查询词覆盖了多个领域,包括医药、教育、电商等,我们也计算了查询词的多样性分数(ILS),与已有数据集相比,我们的查询多样性更高。采样的 230 多万个段落来源于 175 万个文档,平均每个文档被分割为了 1.3 个段落。在训练集中,平均每个查询词有 6.25 个段落被人工标注,而在测试集中,平均每个查询词有 15.75 个段落被人工标注。
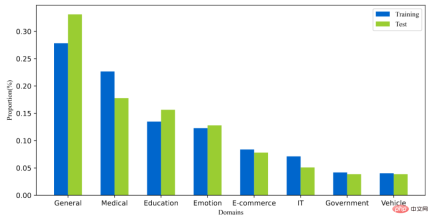
图 4:数据集中查询词的领域分布情况
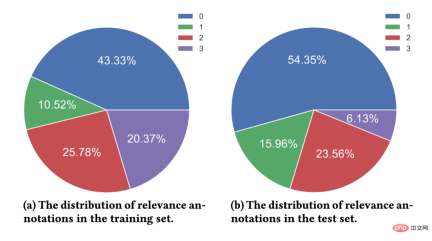
图 5:相关性标注分布情况
常用模型的实验结果
我们在所得到的数据集上,测试了一些常用的段落排序模型的性能,我们同时评测了已有方法在段落召回和段落重排序两个阶段上的性能。
1)段落召回实验
已有的段落召回模型可以被大致分为稀疏召回模型和稠密召回模型。
- 稀疏召回模型关注精确匹配信号来设计相关性打分函数,例如 BM25 就是最具代表性的基准模型。
- 稠密召回模型则采用深度神经网络来学习低维的稠密向量用于表征查询词和段落。
我们测试了以下召回模型的表现:
- QL(query likelihood):QL 是具有代表性的统计语言模型,根据段落生成给定查询词的概率来评价相关性。
- BM25:常用的稀疏召回基准模型。
- DE w/ BM25 Neg:即 DPR 模型,双塔编码器结构(Dual-Encoder),该模型是第一个利用预训练语言模型作为骨干框架的段落召回模型。
- DE w/Mined Neg:双塔编码器结构(Dual-Encoder),通过从全量语料中召回难负例来增强 DPR 模型的性能。
- DPTDR:第一个采用提示微调(prompt tunning)的段落召回模型。
在这些模型中,QL 和 BM25 是稀疏召回模型,其他模型为稠密召回模型。我们采用 MRR,Recall 等常用指标来评价这些模型的性能,实验结果如下表所示:
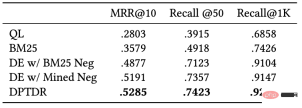
图 6:段落召回模型在测试集上的表现
从实验结果可以看出,相较于传统的稀疏排序模型,稠密检索模型取得了更好的表现。同时引入了难负例对于模型性能的提升也是有帮助的。值得一提的是,这些实验模型在我们数据集上的召回表现要比在其他数据集上的表现差,例如 BM25 在我们的数据集上的 Recall@50 是 0.492,而在 MS-Marco 和 Dureader_retrieval 上是 0.601 和 0.700。这可能是由于我们有更多的段落被进行了人工标注,在测试集中,平均每个查询词下我们有 4.74 个相关文档,这使得召回任务更加具有挑战性且一定程度上降低了假负例的问题。这也说明了 T2Ranking 是一个具有挑战的基准数据集,对未来的召回模型而言有较大的提升空间。
2)段落重排序实验
相比于段落召回阶段,重排序阶段需要考虑的段落规模较小,因此大多数方法倾向于使用交互编码器(Cross-Encoder)作为模型框架,在本工作中,我们测试了交互编码器模型在段落重排序任务上的性能,我们采用 MRR 和 nDCG 作为评价指标,实验效果如下:
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
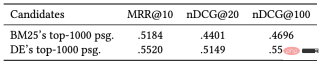
图 7:交互编码器在段落重排序任务上的表现
实验结果表明,在双塔编码器(Dual-Encoder)召回的段落基础上进行重排效果比在 BM25 召回的段落基础上重排能够取得更好的效果,这与已有工作的实验结论一致。与召回实验类似,重排序模型在我们数据集上的表现比在其他数据集上的表现差,这可能是由于我们数据集采用了细粒度标注且具有更高的查询词多样性造成,也进一步说明了我们的数据集是具有挑战性的,并且能够更精确地反映模型性能。
数据集发布团队介绍
该数据集由清华大学计算机系信息检索课题组(THUIR)和腾讯公司 QQ 浏览器搜索技术中心团队共同发布,得到了清华大学天工智能计算研究院的支持。THUIR 课题组聚焦搜索与推荐方法研究,在用户行为建模和可解释学习方法等方面取得了典型成果,课题组成果获得了包括 WSDM2022 最佳论文奖、SIGIR2020 最佳论文提名奖和 CIKM2018 最佳论文奖在内的多项学术奖励,并获得了 2020 年中文信息学会 “钱伟长中文信息处理科学技术奖” 一等奖。QQ 浏览器搜索技术中心团队是腾讯 PCG 信息平台与服务线负责搜索技术研发的团队,依托腾讯内容生态,通过用户研究驱动产品创新,为用户提供图文、资讯、小说、长短视频、服务等多方位的信息需求满足。













