






本篇文章主要介绍了python urllib爬取百度云连接的实例代码,具有一定的参考价值,感兴趣的小伙伴们可以参考一下
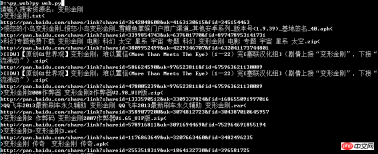
翻看自己以前写的程序,发现写过一个爬取盘多多百度云资源的东西,完全是当时想看变形金刚才自己写的,而且当时第一次接触python大概写了有2天才搞出来这个程序,学习python语言,可以看得出来那时候的代码写的真的low。虽然现在也不怎么样,哈哈,一直学习中,不做过多解释,上图上代码,因为变量的声明是什么我自己也忘了(手动傲娇),连写入文件当时都不会哈哈哈哈哈哈哈哈,也不知道class中可以通过init初始化,唉学习python原来我学到了这么多东西,感谢python

Python 环境工具专业版
下载
Python 环境工具专业版功能概述Python 环境工具专业版是一项面向实际任务的技能。它将相关步骤、工具调用和结果整理方式集中到统一流程中,帮助使用者更快完成目标并减少重复操作。核心要点使用时应结合输入条件选择合适的执行方式,核对必要参数、依赖环境与输出内容,并按原始要求处理异常情况。该技能适合需要稳定复用相关能力的场景,可作为自动化工作流的一部分,也便于后续检查、调整和扩展。执行完成后建议检查结果是否符合预期,并保留必要记录。使用与执行同时注意输入完整性、执行条件和输出可用性。从功能定位来看,该技能
from bs4 import BeautifulSoup
import urllib
import requests
import re

adr =[]

''''对搜素资源名字进行url编码'''
search_text =raw_input('请输入搜索资源名:')
search_text = search_text.decode('gbk')
search_text = search_text.encode('utf-8')
search_text = urllib.quote(search_text)


''''获取文件地址'''
home = urllib.urlopen('http://www.panduoduo.net/s/name/'+search_text)


'''获取百度云地址'''
def getbaidu(adr):
  for i in adr:
    url = urllib.urlopen('http://www.panduoduo.net'+i)
    bs = BeautifulSoup(url)
    bs1 = bs.select('.dbutton2')
    href = re.compile('http\%(\%|\d|\w|\/\/|\/|\.)*')
    b = href.search(str(bs1))
    name = str(bs.select('.center')).decode('utf-8')
    text1 = re.compile('\<h1>[\d|\w|\D|\W]*\</h1>\>')
    text2 = text1.search(name)
    rag1 = re.compile('\>[\d|\w|\D|\W]*\
Python免费学习笔记(深入):立即使用
在学习笔记中,你将探索 Python 的核心概念和高级技巧!














