






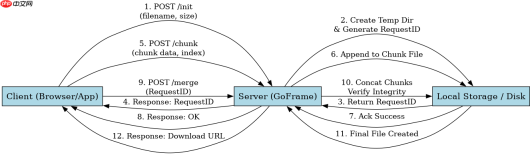
goframe框架实现断点续传的核心做法是:前端将大文件切割为固定大小的分片,每个分片携带唯一的请求id(request id)和分片序号进行上传;服务端接收分片后,将其追加写入到以该请求id命名的临时文件中,并记录已上传的分片信息;当所有分片上传完毕后,前端发起合并请求,服务端根据记录将临时文件中的分片按序拼接成最终文件。这种做法利用了文件系统对追加写入的支持,避免了全量传输失败导致的重复劳动。
如何初始化分片上传任务
在GoFrame中,初始化任务通常通过一个独立的API接口完成,该接口负责生成全局唯一的Request ID,并在本地存储或数据库中创建对应的元数据记录。这一步骤确保了后续所有分片都能被正确关联到同一个上传会话中。开发者需要定义一个结构体来存储分片状态,例如使用map[int]bool来标记哪些分片已经到达,或者直接使用文件系统的原子性操作来避免竞态条件。
package main

import (
    "github.com/gogf/gf/v2/frame/g"
    "github.com/gogf/gf/v2/net/ghttp"
    "github.com/gogf/gf/v2/os/gfile"
    "github.com/gogf/gf/v2/os/gctx"
    "crypto/rand"
    "encoding/hex"
)

// UploadContext 存储上传任务的上下文信息
type UploadContext struct {
    RequestId string
    FileName  string
    TotalSize int64
    ChunkSize int64
    Chunks    map[int]bool // 记录已上传的分片索引
}

var uploadTasks = make(map[string]*UploadContext)

func main() {
    s := g.Server()
    s.Group("/api/upload", func(group *ghttp.RouterGroup) {
        group.POST("/init", InitUpload)
        group.POST("/chunk", UploadChunk)
        group.POST("/merge", MergeChunks)
    })
    s.Run()
}

// InitUpload 初始化上传任务
func InitUpload(r *ghttp.Request) {
    fileName := r.Get("filename").String()
    totalSize := r.Get("total_size").Int64()
    chunkSize := r.Get("chunk_size").Int64()

    // 生成唯一请求ID
    b := make([]byte, 16)
    rand.Read(b)
    requestId := hex.EncodeToString(b)

    // 创建临时目录
    tempDir := gfile.Temp("uploads") + "/" + requestId
    gfile.Mkdir(tempDir)

    // 保存上下文
    ctx := &UploadContext{
        RequestId: requestId,
        FileName:  fileName,
        TotalSize: totalSize,
        ChunkSize: chunkSize,
        Chunks:    make(map[int]bool),
    }
    uploadTasks[requestId] = ctx

    r.Response.WriteJson(g.Map{
        "request_id": requestId,
        "status":     "initialized",
    })
}
如何处理分片上传与断点续传逻辑
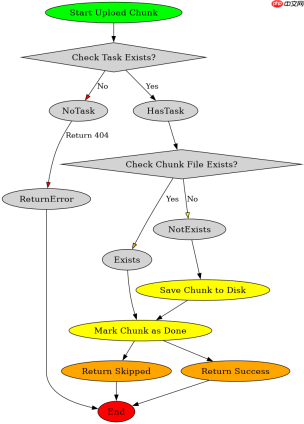
处理分片上传时,关键在于判断当前分片是否已经存在,如果存在则跳过写入以实现断点续传。GoFrame的r.GetFile()方法可以方便地获取上传的文件对象。服务端接收到分片后,应检查临时目录下是否已存在对应序号的文件。若不存在,则将上传的分片内容写入新文件;若存在,则视为该分片已成功上传,直接返回成功状态。这种机制允许客户端在网络中断后重新连接时,仅重传未完成的分片。

// UploadChunk 处理单个分片的上传
func UploadChunk(r *ghttp.Request) {
    requestId := r.Get("request_id").String()
    chunkIndex := r.Get("chunk_index").Int()
    file, err := r.GetFile("chunk")
    if err != nil {
        r.Response.StatusExit(400, "missing chunk file")
    }

    task, ok := uploadTasks[requestId]
    if !ok {
        r.Response.StatusExit(404, "task not found")
    }

    // 构建分片文件路径
    chunkPath := gfile.Join(gfile.Temp("uploads") + "/" + requestId, fmt.Sprintf("%d.dat", chunkIndex))

    // 断点续传逻辑:如果文件已存在,说明该分片已上传,直接返回成功
    if gfile.Exists(chunkPath) {
        task.Chunks[chunkIndex] = true
        r.Response.WriteJson(g.Map{
            "status":   "skipped",
            "message":  "chunk already exists",
            "index":    chunkIndex,
        })
        return
    }

    // 写入分片
    if err := file.Save(chunkPath); err != nil {
        r.Response.StatusExit(500, "save chunk failed")
    }

    task.Chunks[chunkIndex] = true

    r.Response.WriteJson(g.Map{
        "status": "success",
        "index":  chunkIndex,
    })
}
基于合并请求的具体问题如何解决文件完整性校验
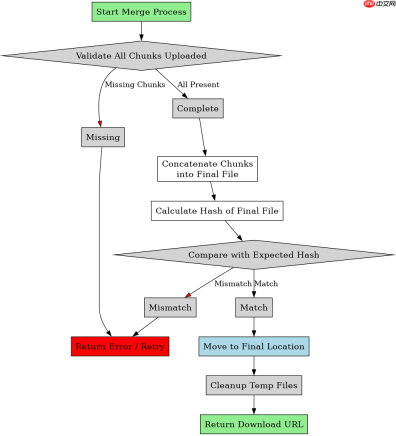
在合并阶段,服务端需要确保所有分片都已上传完毕,并且按照正确的顺序拼接文件。一个具体的问题是:如何验证合并后的文件与原始文件一致?虽然分片上传本身保证了数据的逐块传递,但为了防止传输过程中的静默错误,可以在合并完成后计算最终文件的哈希值(如MD5或SHA256),并与前端传来的原始文件哈希进行比对。如果比对不一致,则拒绝重命名文件并删除临时目录,提示用户重新上传。此外,合并操作应使用os.OpenFile配合io.Copy或简单的文件读取写入循环,确保大文件不会占用过多内存。












