






在xorm框架中为数据表建立复合联合索引,最直接且推荐的做法是在结构体字段上添加 `xorm:"index"` 标签,并将多个字段依次排列在同一标签字符串中。这样生成的sql语句会创建一个包含所有指定字段的联合索引,能够显著提升多条件查询的性能。
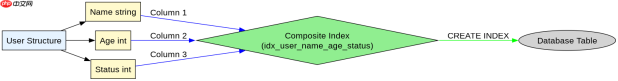
如何定义包含三个字段的联合索引
当需要针对三个或更多字段进行联合查询时,只需在 `xorm:"index"` 标签的引号内按顺序列出字段名,并用空格分隔即可。XORM会自动将这些字段映射到数据库的同一个索引结构中。例如,定义一个包含 `Name`、`Age` 和 `Status` 三个字段的联合索引,可以在结构体中直接声明。
package main

import (
	"fmt"
	"log"
	"time"

	"xorm.io/xorm"
)

type User struct {
	ID     int64     `xorm:"pk autoincr"`
	Name   string    `xorm:"unique index idx_user_name_age_status"`
	Age    int       `xorm:"index idx_user_name_age_status"`
	Status int       `xorm:"index idx_user_name_age_status"`
	Created time.Time `xorm:"created"`
}

func main() {
	engine, err := xorm.NewEngine("mysql", "root:root@/test?charset=utf8mb4")
	if err != nil {
		log.Fatal(err)
	}

	// Sync2 会自动创建或更新表结构及索引
	err = engine.Sync2(new(User))
	if err != nil {
		log.Fatal(err)
	}

	// 验证索引是否创建成功
	indexes, err := engine.Indexes(new(User))
	if err != nil {
		log.Fatal(err)
	}

	for name, index := range indexes {
		fmt.Printf("Index Name: %s\n", name)
		for _, col := range index.Cols {
			fmt.Printf("  - Column: %s\n", col)
		}
	}
}
运行上述代码后,控制台将输出类似如下的信息,确认联合索引已创建:
Index Name: idx_user_name_age_status
  - Column: name
  - Column: age
  - Status: status
注意:如果希望索引名称更具可读性,可以在标签中使用 `name=idx_name` 语法自定义索引名,例如 `xorm:"index(name=idx_user_info)"`,并在后续字段中引用该名称。
如何处理已有表结构的索引更新
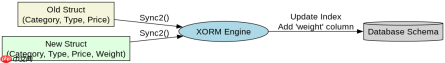
在开发过程中,如果已经存在数据表并需要修改或新增联合索引,XORM的 `Sync2` 方法能够智能地处理模式变更。它不会删除现有数据,而是根据结构体标签的定义,自动添加缺失的索引或删除不再需要的索引。对于联合索引,只要结构体中的字段顺序和标签保持一致,`Sync2` 就能正确识别并更新数据库中的索引定义。
package main

import (
	"fmt"
	"log"

	"xorm.io/xorm"
)

type Product struct {
	ID        int64  `xorm:"pk autoincr"`
	Category  string `xorm:"index idx_prod_cat_type_price"`
	Type      string `xorm:"index idx_prod_cat_type_price"`
	Price     float64 `xorm:"index idx_prod_cat_type_price"`
	IsDeleted bool   `xorm:"deleted"`
}

func main() {
	engine, err := xorm.NewEngine("sqlite3", "./test.db")
	if err != nil {
		log.Fatal(err)
	}

	// 首次同步
	fmt.Println("First sync:")
	err = engine.Sync2(new(Product))
	if err != nil {
		log.Fatal(err)
	}

	// 模拟修改:增加一个新字段并调整索引
	type ProductV2 struct {
		ID        int64   `xorm:"pk autoincr"`
		Category  string  `xorm:"index idx_prod_v2"`
		Type      string  `xorm:"index idx_prod_v2"`
		Price     float64 `xorm:"index idx_prod_v2"`
		Weight    float64 `xorm:"index idx_prod_v2"` // 新增字段
		IsDeleted bool    `xorm:"deleted"`
	}

	fmt.Println("Second sync (adding Weight field):")
	err = engine.Sync2(new(ProductV2))
	if err != nil {
		log.Fatal(err)
	}

	// 检查最终索引状态
	indexes, err := engine.Indexes(new(ProductV2))
	if err != nil {
		log.Fatal(err)
	}

	for name, index := range indexes {
		fmt.Printf("Final Index: %s with columns: %v\n", name, index.Cols)
	}
}
通过这种方式,开发者可以专注于业务逻辑,而无需手动编写复杂的DDL语句来管理索引变更。XORM会根据结构体的定义与数据库实际状态的差异,执行必要的 `ADD INDEX` 或 `DROP INDEX` 操作,确保数据库结构与代码保持同步。
基于结构体标签中字段顺序的具体问题
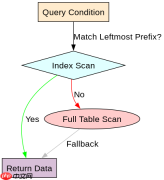
在XORM中定义联合索引时,结构体标签中字段的排列顺序直接决定了数据库中联合索引的列顺序。这一顺序至关重要,因为它遵循最左前缀原则(Leftmost Prefixing)。这意味着查询条件必须从索引的第一个字段开始匹配,才能有效利用该联合索引。如果查询跳过了第一个字段,即使包含了后续字段,数据库优化器也可能无法使用该索引进行高效查找。












