






使用 inner join 处理一对多关系时,只需在 from 子句中指定主表,通过 on 条件关联从表即可获取所有匹配记录。这种操作会生成笛卡尔积的局部结果,即主表的每一行会与从表中所有符合条件的行组合,导致主表数据在多行中重复出现。开发者应明确这种行数膨胀是预期行为,并在后续查询或应用层逻辑中处理聚合需求。
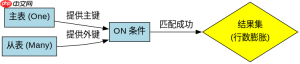
INNER JOIN 如何连接主表与从表
当执行 INNER JOIN 时,数据库引擎会遍历主表中的每一行,并在从表中查找满足 ON 条件的行。如果找到匹配项,则将两行的列合并为一行输出;如果没有找到匹配项,则该行被丢弃。在一对多关系中,主表的一行通常对应从表的多行,因此输出结果集中主表的主键值会重复出现多次,每次对应一个不同的从表记录。
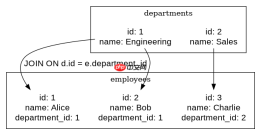
CREATE TABLE departments (
    id INT PRIMARY KEY,
    name VARCHAR(50)
);

CREATE TABLE employees (
    id INT PRIMARY KEY,
    name VARCHAR(50),
    department_id INT,
    FOREIGN KEY (department_id) REFERENCES departments(id)
);

INSERT INTO departments VALUES (1, 'Engineering'), (2, 'Sales');
INSERT INTO employees VALUES (1, 'Alice', 1), (2, 'Bob', 1), (3, 'Charlie', 2);

SELECT d.name AS dept_name, e.name AS emp_name
FROM departments d
INNER JOIN employees e ON d.id = e.department_id;
上述 SQL 语句将返回三行结果:'Engineering' 对应 'Alice','Engineering' 对应 'Bob','Sales' 对应 'Charlie'。注意 'Engineering' 出现了两次,因为该部门有两名员工。这是 INNER JOIN 在一对多关系中的标准行为,确保了所有关联数据的完整性。
如何处理 JOIN 后的数据聚合
由于 INNER JOIN 会导致主表数据重复,直接统计主表行数或使用 DISTINCT 可能无法得到预期的业务指标。通常需要使用 GROUP BY 对主表进行分组,并结合聚合函数如 COUNT、SUM 来计算从表的相关统计值。例如,计算每个部门的员工数量,需要对部门 ID 进行分组并计数员工 ID。
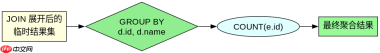
SELECT d.id, d.name, COUNT(e.id) AS employee_count
FROM departments d
INNER JOIN employees e ON d.id = e.department_id
GROUP BY d.id, d.name;
执行上述查询后,结果集将包含两行:部门 'Engineering' 的员工数量为 2,部门 'Sales' 的员工数量为 1。这种聚合方式有效地将一对多的展开结果重新汇总为主表维度的统计信息,避免了数据重复带来的误导。开发者应根据具体需求决定是直接展开明细还是进行聚合统计。
INNER JOIN 在缺少匹配记录时的行为
如果主表中的某一行在从表中没有对应的匹配记录,INNER JOIN 会直接排除该行,不会出现在结果集中。这与 LEFT JOIN 不同,LEFT JOIN 会保留主表行并用 NULL 填充从表列。在一对多关系中,这意味着如果某个部门没有任何员工,该部门的信息将完全消失。开发者需确认业务逻辑是否允许这种数据丢失,若需保留无员工的部门,应改用 LEFT JOIN。


