






sql自连接查询导致cpu飙升至100%的核心原因是产生了指数级的笛卡尔积,使得数据库引擎在内存中处理的数据量远超预期。要解决这个问题,必须为参与连接的列建立索引,并检查是否存在缺少过滤条件的全表扫描。通过添加适当的where子句限制匹配范围,可以将时间复杂度从o(n²)降低到可接受的水平。

为什么没有索引的自连接会耗尽CPU资源
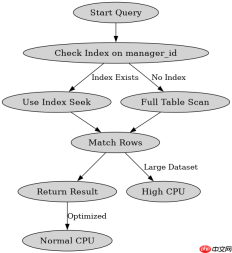
当对一个大表进行自连接且未使用索引时,数据库优化器通常会选择嵌套循环连接(Nested Loop Join)。这意味着对于左表的每一行,它都需要扫描右表的所有行来寻找匹配项。如果表中有N行,操作次数约为N乘以N。这种全表扫描和大量的磁盘I/O等待转换成了极高的CPU上下文切换和计算开销,最终导致CPU使用率达到100%。
CREATE TABLE employees ( id INT PRIMARY KEY, name VARCHAR(50), manager_id INT ); INSERT INTO employees VALUES (1, 'Alice', NULL); INSERT INTO employees VALUES (2, 'Bob', 1); INSERT INTO employees VALUES (3, 'Charlie', 1); INSERT INTO employees VALUES (4, 'David', 2); -- 低效查询:无索引,导致全表扫描 SELECT e1.name AS employee, e2.name AS manager FROM employees e1 JOIN employees e2 ON e1.manager_id = e2.id;
预期结果:如果employees表有百万级数据,上述查询将执行极长时间并占用大量CPU。若为manager_id添加索引,查询速度将显著提升。
如何优化自连接查询以避免性能瓶颈
优化自连接的关键在于减少需要比较的行数。最直接的方法是在连接条件涉及的列上创建索引,这样数据库可以使用索引快速定位匹配行,而不是扫描整个表。此外,确保JOIN条件中包含足够的过滤条件,避免产生不必要的中间结果集。如果可能,考虑使用窗口函数或CTE(公共表表达式)来替代复杂的自连接逻辑。
-- 优化后的查询:利用索引 CREATE INDEX idx_manager_id ON employees(manager_id); -- 高效查询 SELECT e1.name AS employee, e2.name AS manager FROM employees e1 JOIN employees e2 ON e1.manager_id = e2.id WHERE e1.manager_id IS NOT NULL;
预期结果:添加索引后,查询计划将从全表扫描变为索引查找,CPU使用率恢复正常水平。WHERE子句进一步排除了空值,减少了无效连接。
自连接查询中常见的死锁与锁竞争问题
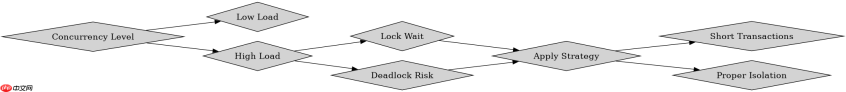
在高并发场景下,自连接查询不仅消耗CPU,还可能引发锁竞争。由于自连接涉及同一张表,多个事务同时读取和写入该表的不同部分时,可能会形成锁等待链,导致死锁或严重的锁阻塞。这种现象在长事务或大事务中尤为明显。解决策略包括缩短事务持续时间、使用合适的隔离级别(如READ COMMITTED),以及避免在自连接中更新被连接的其他行。


