






在postgresql 14中优化大批量json数据的join,核心做法是避免对json字段进行运行时解析和函数调用,而是将json数据提取为物理存储的列并建立索引。具体而言,应使用生成列(generated columns)或触发器将json中的关键字段持久化到普通数据类型列中,随后对这些列创建b-tree索引。这样做可以将原本昂贵的`jsonb_path_query`或`->>`操作转化为高效的索引扫描,从而显著降低join操作的cpu开销和执行时间。

为什么直接JOIN JSON字段性能差
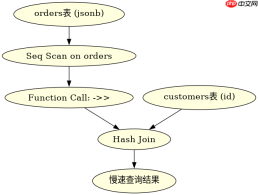
直接在JSON字段上进行JOIN会导致全表扫描和逐行解析,因为数据库无法利用索引加速非结构化数据的匹配。当两个大表通过`jsonb`类型关联时,PostgreSQL必须对每一行的JSON文档进行反序列化并提取键值,这在数据量大时会产生巨大的I/O和CPU负担。这种模式通常表现为执行计划中出现大量的`Seq Scan`和`Function Call`,且无法有效利用并行处理。
CREATE TABLE orders (
    id SERIAL PRIMARY KEY,
    data jsonb NOT NULL
);

-- 低效查询:直接对JSON字段进行JOIN
SELECT o.id, c.name
FROM orders o
JOIN customers c ON o.data->>'customer_id' = c.id;
上述代码展示了典型的低效模式。`orders`表若包含百万级记录,每次查询都需要遍历所有行并解析`data`字段。预期结果是查询耗时随数据量线性增长,且无法通过常规索引优化。实际测试中,此类查询在100万行数据下可能耗时数秒至数十秒,而优化后应降至毫秒级。
如何使用生成列和索引优化JOIN
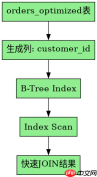
使用生成列将JSON中的关键字段提取为物理列并建立索引,是实现高效JOIN的标准做法。通过在表定义中添加`GENERATED ALWAYS AS (...) STORED`子句,数据库会在插入或更新时自动计算并存储提取的值,后续查询可直接利用该列的索引。这种方法将JSON解析成本从查询时转移到写入时,适合读多写少的场景。

exa-js 是 Exa 官方 JavaScript 软件开发工具包,Exa 是一个为 AI 工作流构建的网络搜索 API。它为代理提供了一种具体的方式来搜索网络、检索页面内容,并从代码中生成有来源的答案,而不是手动拼接原始 HTTP 调用。
CREATE TABLE orders_optimized (
    id SERIAL PRIMARY KEY,
    data jsonb NOT NULL,
    customer_id INT GENERATED ALWAYS AS (data->>'customer_id')::INT STORED
);

CREATE INDEX idx_orders_customer_id ON orders_optimized(customer_id);

-- 高效查询:利用生成列的索引
SELECT o.id, c.name
FROM orders_optimized o
JOIN customers c ON o.customer_id = c.id;
此代码演示了优化后的结构。`customer_id`作为生成列被物理存储,并通过`idx_orders_customer_id`索引加速查找。预期结果是JOIN操作变为`Index Scan`,查询速度提升数个数量级。需注意,生成列会增加存储空间和写入延迟,因此仅应对高频JOIN的字段使用。
生成列在复杂JSON嵌套中的表现
当JSON数据存在多层嵌套时,生成列仍能准确提取目标值,但表达式需精确匹配路径。例如,若`customer_id`位于`data->'address'->'primary'`路径下,生成列表达式应反映这一结构。PostgreSQL 14支持在生成列中使用复杂的JSON操作符,确保提取逻辑与业务需求一致。验证时需检查提取值的类型转换是否正确,避免因类型不匹配导致索引失效。


