






java 中通过编码提供者传输扩展编码,核心做法是调用 charsetdecoder 的 onmalformedinput 和 onunmappablecharacter 方法,将处理策略设置为 codingerroraction.ignore 或 codingerroraction.replace。这样在遇到无法识别的字节序列时,解码器不会抛出异常,而是直接忽略或替换为默认字符,从而允许程序继续处理包含非标准编码内容的输入流。

CharsetDecoder 如何处理未映射字符
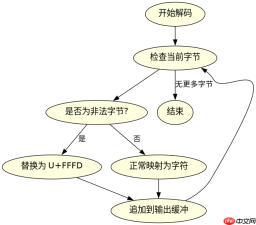
当使用标准的 StandardCharsets.UTF_8 等内置编码时,遇到非法字节会立即抛出 MalformedInputException。要解决这个问题,需要手动获取解码器实例并配置其错误处理行为。通过设置 REPLACE 动作,解码器会将无法解析的字节替换为 Unicode 替换字符(U+FFFD),确保数据流不断裂。
import java.nio.ByteBuffer;
import java.nio.CharBuffer;
import java.nio.charset.Charset;
import java.nio.charset.CharsetDecoder;
import java.nio.charset.CodingErrorAction;

public class DecoderExample {
    public static void main(String[] args) {
        // 假设我们有一个包含非法 UTF-8 字节的数组
        byte[] data = { (byte) 0xFF, (byte) 0xFE, 'H', 'i' };
        ByteBuffer input = ByteBuffer.wrap(data);
        CharBuffer output = CharBuffer.allocate(10);

        // 获取 UTF-8 解码器
        CharsetDecoder decoder = Charset.forName("UTF-8").newDecoder();

        // 关键步骤:设置未映射字符的处理方式为 REPLACE
        decoder.onUnmappableCharacter(CodingErrorAction.REPLACE);
        decoder.onMalformedInput(CodingErrorAction.REPLACE);

        try {
            // 执行解码
            CoderResult result = decoder.decode(input, output, true);
            if (result.isOverflow()) {
                System.out.println("输出缓冲区溢出");
            }
            output.flip();
            System.out.println("解码结果: " + output.toString());
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
运行上述代码,预期输出为:解码结果: Hi。其中 代表被替换的两个非法字节。这证明了通过配置 CodingErrorAction,我们可以让解码器容忍部分编码错误,从而实现“传输”扩展或非标准编码内容的能力。
自定义 Charset 实现扩展编码支持
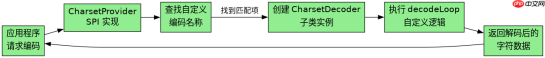
如果内置编码无法满足需求,例如需要支持某种特定的私有编码格式,可以通过继承 Charset 类并重写 newDecoder() 方法来创建自定义编码提供者。这种方法允许开发者完全控制字节到字符的转换逻辑,适用于处理遗留系统或特定协议中的非标准编码。

使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。
import java.nio.CharBuffer;
import java.nio.charset.Charset;
import java.nio.charset.CharsetDecoder;
import java.nio.charset.spi.CharsetProvider;
import java.util.Locale;

public class CustomCharsetProvider extends CharsetProvider {

    @Override
    public Charset[] supportedCharsets() {
        return new Charset[]{ new MyCustomCharset() };
    }

    @Override
    public Charset charsetForName(String charsetName) {
        if ("MY_CUSTOM_ENCODING".equalsIgnoreCase(charsetName)) {
            return new MyCustomCharset();
        }
        return null;
    }

    // 内部静态类实现具体编码逻辑
    private static class MyCustomCharset extends Charset {
        protected MyCustomCharset() {
            super("MY_CUSTOM_ENCODING", new String[]{ "my-custom" });
        }

        @Override
        public boolean contains(Charset cs) {
            return false;
        }

        @Override
        public CharsetDecoder newDecoder() {
            return new CharsetDecoder(this, 1.0f, 1.0f) {
                @Override
                protected CoderResult decodeLoop(ByteBuffer in, CharBuffer out) {
                    while (in.hasRemaining()) {
                        byte b = in.get();
                        if (b == 0x80) {
                            if (!out.hasRemaining()) return CoderResult.OVERFLOW;
                            out.put('€'); // 假设 0x80 映射为欧元符号
                        } else {
                            if (!out.hasRemaining()) return CoderResult.OVERFLOW;
                            out.put((char) b); // 其他字节直接映射
                        }
                    }
                    return CoderResult.UNDERFLOW;
                }
            };
        }
    }
}
此示例定义了一个名为 MY_CUSTOM_ENCODING 的自定义编码。在实际使用中,可以通过 Charset.forName("MY_CUSTOM_ENCODING") 获取该编码,并使用其提供的 newDecoder() 进行解码。这种机制允许应用程序通过 SPI(服务提供者接口)动态加载和扩展编码支持,而无需修改 JDK 核心代码。
如何验证自定义编码的解码结果
为了验证自定义编码是否正确工作,可以构造一组已知的测试数据,包括正常字节和特殊映射字节,然后使用自定义解码器进行解码并检查结果。这一步骤确保了编码提供者的实现符合预期,特别是在处理边界条件和特殊字符映射时。
import java.nio.ByteBuffer;
import java.nio.CharBuffer;
import java.nio.charset.Charset;
import java.nio.charset.CharsetDecoder;

public class VerificationTest {
    public static void main(String[] args) {
        // 注册自定义编码(实际项目中通常在静态块或服务加载时完成)
        // 这里简化演示,直接使用内部类
        Charset customCharset = new CustomCharsetProvider().charsetForName("MY_CUSTOM_ENCODING");

        if (customCharset != null) {
            byte[] testData = { 0x48, 0x69, 0x80 }; // 'H', 'i', and special char
            ByteBuffer input = ByteBuffer.wrap(testData);
            CharBuffer output = CharBuffer.allocate(10);

            CharsetDecoder decoder = customCharset.newDecoder();
            try {
                decoder.decode(input, output, true);
                output.flip();
                String result = output.toString();
                System.out.println("验证结果: " + result);
                // 预期输出: Hi€
            } catch (Exception e) {
                e.printStackTrace();
            }
        } else {
            System.out.println("自定义编码未找到");
        }
    }
}
运行验证测试,预期输出为:验证结果: Hi€。这表明自定义编码提供者成功将字节 0x80 映射为欧元符号,而其他字节按 ASCII 码映射。通过这种方式,开发者可以确信扩展编码在传输和处理过程中能够正确解析非标准数据。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


