






java中利用循环实现批量更新的核心做法是:将数据分批(例如每批100条)放入list,在循环体内调用jdbc的批量执行方法,最后统一提交事务。这样做能显著减少网络往返次数并提高吞吐量。若遇到主键冲突或唯一索引约束,需捕获异常并根据业务需求决定是跳过、重试还是回滚整批。
如何配置JDBC以支持高效的批量操作
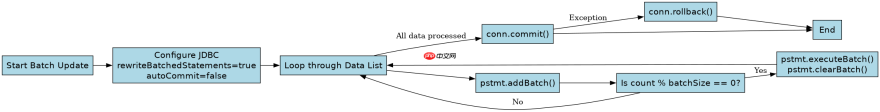
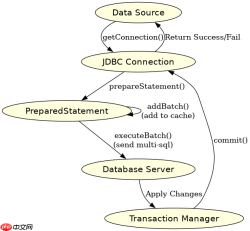
要实现高效的批量更新,必须在建立数据库连接时配置特定的URL参数,并在代码中使用addBatch()和executeBatch()方法。默认情况下,JDBC驱动可能会逐条发送SQL,导致性能极差。通过设置rewriteBatchedStatements=true,MySQL驱动会将多条INSERT/UPDATE语句合并为一条多值语句发送,极大提升速度。同时,需要关闭自动提交(autoCommit=false),以便手动控制事务边界,确保要么全部成功,要么全部失败。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.util.ArrayList;
import java.util.List;

public class BatchUpdateExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/test?rewriteBatchedStatements=true";
        String user = "root";
        String password = "password";

        // 模拟待更新的数据列表
        List<string> dataToProcess = new ArrayList();
        for (int i = 0; i <p>上述代码展示了标准的批量更新流程。首先加载驱动并获取连接,随后关闭自动提交。在循环中,使用<code>PreparedStatement</code>设置参数并调用<code>addBatch()</code>将其加入队列。当累积到设定的<code>batchSize</code>(如100)时,调用<code>executeBatch()</code>发送给数据库,并立即调用<code>clearBatch()</code>清空缓存,防止内存溢出。循环结束后,再次执行剩余的批次并提交事务。如果任何步骤抛出异常,进入catch块执行<code>rollback()</code>保证数据一致性。</p>
<h2>如何处理批量更新中的异常与部分失败情况</h2>
<p>在实际生产环境中,批量更新常因数据质量问题(如重复主键、类型不匹配)导致部分记录失败。JDBC的<code>executeBatch()</code>返回一个<code>int[]</code>数组,其中每个元素表示对应SQL语句的执行状态:-2表示执行成功但影响行数未知,0表示未执行,其他正值表示受影响行数。负值通常意味着错误。为了稳健处理,应遍历该返回值,对非正数项进行单独处理或记录日志,而不是简单地中断整个批次。此外,可以结合<code>Statement.SUCCESS_NO_INFO</code>常量来判断。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill13718" title="使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20dee630206.jpg" alt="使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill13718" title="使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查" class="overflowclass">使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查</a>
													<p class="overflowclass">使用 Husky 将 pre-commit、pre-push 和 commit-msg 检查集成到仓库中,以便代理和开发人员在更改离开工作站之前运行相同的本地防护措施。</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill13718" title="使用 Husky 在 JavaScript 仓库中强制执行本地 Git 钩子检查" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div>
<p><img src="https://img.php.cn/upload/article/001/242/473/179530699887555.png?x-oss-process=image/resize,p_40" alt="Java 流程控制怎么用循环实现批量更新"></p>
<pre class="brush:php;toolbar:false;">import java.sql.BatchUpdateException;
import java.sql.Statement;

// ... 在 executeBatch() 之后 ...
try {
    int[] results = pstmt.executeBatch();
    for (int i = 0; i  0) {
            System.out.println("Row " + i + " updated successfully.");
        } else if (results[i] == 0) {
            System.out.println("Row " + i + " was not executed or affected 0 rows.");
        } else {
            System.err.println("Row " + i + " failed with code: " + results[i]);
            // 这里可以记录具体失败的行号和数据,用于后续重试或人工干预
        }
    }
} catch (BatchUpdateException bue) {
    // 捕获批量更新期间的异常
    int[] results = bue.getUpdateCounts();
    for (int i = 0; i = 0) {
             System.out.println("Pre-failure row " + i + " succeeded.");
        } else {
             System.err.println("Failed at row " + i);
        }
    }
    throw bue; // 重新抛出以触发事务回滚
}
这段代码演示了如何解析executeBatch()的结果。通过检查返回数组中的每个值,开发者可以精确知道哪些行更新成功,哪些失败。对于失败的行,可以根据业务逻辑选择忽略、记录日志或存入死信队列。如果使用的是MySQL且开启了rewriteBatchedStatements,有时单个语句的错误可能导致整个批次被拒绝,此时BatchUpdateException会被抛出,其内部仍包含已执行成功的计数信息。理解这些细节有助于构建更健壮的批量处理系统。
当单条更新耗时过长时如何优化批次大小
如果批量更新过程中发现某一批次执行时间显著长于其他批次,或者出现内存溢出(OOM)风险,调整batchSize是关键优化手段。过大的批次会导致单次SQL语句体积过大,占用大量网络带宽和数据库解析资源;过小则无法发挥批量优势。一般建议从100-500条开始测试,根据数据库负载和网络延迟动态调整。对于包含大字段(如TEXT/BLOB)的记录,批次大小应适当减小。此外,可以使用setFetchSize()优化结果集处理,但在纯更新操作中作用有限。监控数据库服务器的CPU和IO指标,找到吞吐量峰值对应的批次大小是最可靠的方法。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南


