






解决 nginx 代理响应乱码的核心做法是确保 nginx 与后端应用之间的字符集编码一致,并在 nginx 配置中显式声明正确的 charset。通常需要在 location 块中使用 charset 指令指定编码(如 utf-8),同时检查后端返回的 http 头中 content-type 是否包含正确的 charset 参数。如果后端未正确设置或 nginx 缓存了错误编码,可能导致浏览器解析出错。
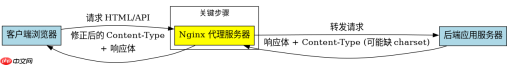
Nginx 如何强制指定响应编码以覆盖后端缺失的 Header
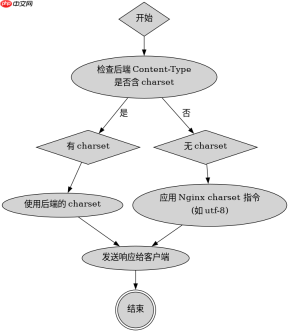
当后端应用没有返回 Content-Type 中的 charset 信息,或者返回了错误的编码标识时,Nginx 可以通过 charset 指令强制覆盖响应的字符集。这能确保浏览器按照指定的编码(通常是 UTF-8)解析内容,从而避免乱码。该指令会在 Nginx 发送响应头时自动添加或修改 Content-Type 中的 charset 部分。
server {
    listen 80;
    server_name example.com;

    location /api/ {
        proxy_pass http://backend_server;
        # 强制指定响应编码为 UTF-8
        charset utf-8;

        # 可选:清除后端可能存在的错误 Content-Type
        proxy_set_header Accept-Encoding '';
    }
}
上述配置中,charset utf-8; 是关键。它告诉 Nginx 将响应体视为 UTF-8 编码,并相应地设置响应头。即使后端返回 Content-Type: text/html(无 charset),Nginx 也会将其修正为 Content-Type: text/html; charset=utf-8。这对于处理动态生成的中文内容非常有效。
如何处理后端返回 Gzip 压缩导致的编码识别失败
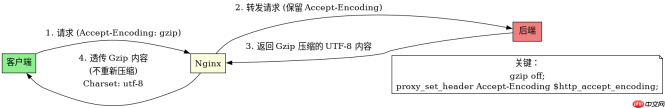
当后端启用 Gzip 压缩时,Nginx 作为反向代理可能需要重新压缩或直接透传。如果 Nginx 尝试对已压缩的内容进行解码或重新编码,可能会导致数据损坏或编码识别混乱。此时,应确保 Nginx 正确处理压缩流,并避免在压缩层干扰字符集判断。通过设置 proxy_set_header Accept-Encoding 和控制 gzip 行为,可以维持编码一致性。

server {
    listen 80;
    server_name example.com;

    location /api/ {
        proxy_pass http://backend_server;
        charset utf-8;

        # 禁止 Nginx 重新压缩,直接透传后端的压缩内容
        gzip off;

        # 保持后端的 Accept-Encoding 头,让后端决定压缩方式
        proxy_set_header Accept-Encoding $http_accept_encoding;
    }
}
在这个场景中,gzip off; 防止 Nginx 对响应体进行二次压缩,从而避免因压缩算法与字符集转换冲突导致的潜在问题。同时,proxy_set_header Accept-Encoding $http_accept_encoding; 确保后端知道客户端支持压缩,并能正确返回压缩后的 UTF-8 内容。结合 charset utf-8;,Nginx 能正确识别并传递编码信息给客户端。
当后端返回非 UTF-8 编码(如 GBK)时 Nginx 如何转换
如果后端应用使用 GBK 等非 UTF-8 编码,而客户端期望 UTF-8,Nginx 本身不提供直接的编码转换功能。此时,最佳实践是在后端修改为返回 UTF-8。若无法修改后端,可在 Nginx 中通过 charset 指定为 GBK,但这仅改变响应头,不转换内容,可能导致浏览器显示乱码。因此,必须确保后端输出与 charset 指令匹配。例如,若后端固定输出 GBK,则设置 charset gbk;,并确保浏览器能正确解析。


