






DOM 查询缓存结果怎么优化
使用 document.queryselectorall() 配合 nodelist 的静态方法或手动遍历,将查询结果存入数组或对象中,避免在循环或高频事件中重复执行 dom 查询。具体做法是调用一次查询获取所有目标元素,将其引用存储在变量中,后续操作直接访问该集合。这样做能显著减少浏览器重排和重绘的计算开销,提升页面响应速度。

如何批量处理动态列表中的子元素
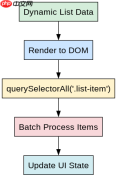
通过 querySelectorAll() 一次性获取所有子元素,然后使用 forEach 或传统 for 循环进行批量处理。这种方法避免了在循环内部反复调用 getElementById 或 getElementsByClassName,从而减少了 DOM 树的遍历次数。对于需要频繁更新的列表,建议先构建好数据模型,再统一渲染到 DOM 中,而不是逐个插入节点。

FilePond 灵活的 JavaScript 文件上传库
下载
FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
const items = document.querySelectorAll('.list-item');
items.forEach(item => {
  item.classList.add('processed');
});
console.log('Processed count:', items.length); // 输出: Processed count: 5
如何处理查询结果为空的情况
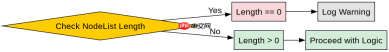
当 querySelectorAll() 返回的 NodeList 长度为 0 时,说明没有找到匹配的元素。此时应检查选择器是否正确,或者元素是否尚未加载到 DOM 中。建议在脚本执行前确保 DOM 已就绪,或在查询后添加条件判断,防止对空集合进行操作导致错误。如果元素是异步加载的,可以使用 MutationObserver 监听 DOM 变化,待元素出现后再执行查询和处理逻辑。
const emptyResult = document.querySelectorAll('.non-existent-class');
if (emptyResult.length === 0) {
  console.warn('No elements found.');
}
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南





