






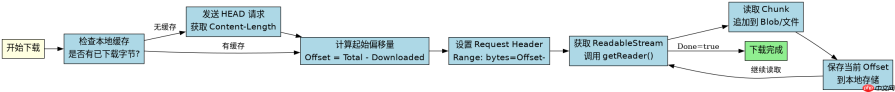
javascript fetch api 实现请求数据断点续传的核心做法是:利用 http 协议的 range 请求头向服务器声明从哪个字节位置开始下载,并通过读取 readablestream 的 getreader() 方法手动控制数据流的读取与拼接。具体步骤包括先发送不带 range 头的请求获取文件总大小(或解析 accept-ranges),计算已下载的本地字节偏移量,随后在发起正式下载请求时设置 headers: { 'range': `bytes=${offset}-` },并将响应体的流式数据追加到已有的 blob 或文件中,从而在连接中断后恢复传输。
如何获取文件的总大小以确定续传起点
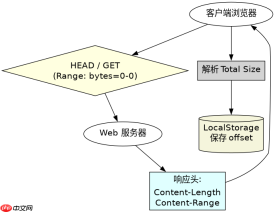
要实现断点续传,第一步必须知道文件的总长度以及当前已经成功下载了多少字节。这通常通过发送一个 HEAD 请求或者带有 Range: bytes=0-0 的 GET 请求来实现。服务器会在响应中返回 Content-Length 和 Content-Range 头部信息,客户端据此计算出剩余未下载的数据量。如果本地没有保存过进度,则起点为 0;如果之前中断过,则读取本地存储的进度记录作为新的起点。
const url = 'https://example.com/large-file.zip';

async function getFileSize(url) {
  const response = await fetch(url, { method: 'HEAD' });
  if (response.ok) {
    return parseInt(response.headers.get('Content-Length'), 10);
  }
  // 如果 HEAD 不支持,尝试 Range: bytes=0-0
  const rangeResponse = await fetch(url, {
    headers: { 'Range': 'bytes=0-0' }
  });
  const contentRange = rangeResponse.headers.get('Content-Range');
  if (contentRange) {
    const total = contentRange.split('/')[1];
    return parseInt(total, 10);
  }
  throw new Error('无法获取文件大小');
}
如何利用 Stream 和 Range 头实现分段下载
确定起点后,使用 fetch 发起带有 Range 头的请求。由于 fetch 默认返回的是完整的 Body,为了支持断点续传,我们需要访问底层的 ReadableStream。通过调用 body.getReader() 获取读取器,然后在循环中逐个读取数据块(Chunk)。每读取一个块,就将其追加到预先创建的 Blob 部分或写入本地文件系统。这种方式允许我们在网络波动时暂停读取,保存当前偏移量,下次继续从该偏移量对应的流位置开始读取,从而实现真正的断点续传。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。

async function downloadWithResume(url, savedOffset = 0) {
  const totalSize = await getFileSize(url);
  const blobParts = [];

  const response = await fetch(url, {
    headers: { 'Range': `bytes=${savedOffset}-` }
  });

  if (!response.body) throw new Error('No body');
  const reader = response.body.getReader();
  let receivedLength = savedOffset; // 累计接收长度

  while(true) {
    const {done, value} = await reader.read();
    if (done) break;

    blobParts.push(value);
    receivedLength += value.length;
    console.log(`Downloaded: ${receivedLength}/${totalSize}`);

    // 这里可以添加暂停逻辑,例如检查用户是否点击了暂停
    // 并保存 receivedLength 到 localStorage 或 IndexedDB
  }

  const finalBlob = new Blob(blobParts);
  return finalBlob;
}
如何处理下载过程中的异常与状态保存
在实际应用中,网络请求可能会因为超时、断开或服务器错误而失败。为了实现可靠的断点续传,必须在每次成功读取一个数据块后,立即将当前的 receivedLength 保存到持久化存储(如 localStorage 或 IndexedDB)中。当捕获到异常时,不应直接抛出错误终止程序,而是应记录错误状态并保留当前的偏移量。下次用户触发下载时,程序首先检查是否有未完成的下载记录,如果有,则使用该记录中的偏移量重新发起请求。此外,还需要处理服务器不支持 Range 请求的情况,此时应回退到从头下载的逻辑。
大量免费API接口:立即使用
涵盖生活服务API、金融科技API、企业工商API、等相关的API接口服务。免费API接口可安全、合规地连接上下游,为数据API应用能力赋能!





