






排查 linux 丢包问题,核心做法是使用 tcpdump 在网卡接口进行抓包,通过对比发送端与接收端的报文数量差异来定位丢包位置。具体操作时,需指定正确的网络接口(如 -i eth0)并设置过滤条件以缩小范围,例如按 ip 或端口过滤。若发现接收端报文少于发送端,则说明中间链路或网卡存在丢包;若收发一致但应用层未收到,则可能是防火墙或应用配置问题。

如何正确启动 tcpdump 抓包并过滤特定流量
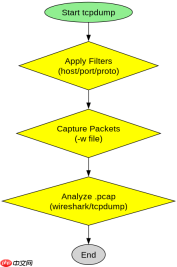
要开始抓包,必须明确目标网卡和流量特征。使用 tcpdump -i 可以捕获指定接口的所有数据包。为了减少噪音,通常结合 host、port 或 proto 等过滤器。例如,抓取与特定服务器通信的 TCP 流量,命令为 tcpdump -i eth0 host 192.168.1.100 and port 80。执行后,终端会实时显示数据包摘要,包括时间戳、IP 地址、协议类型及标志位(如 SYN, ACK, FIN)。若需保存原始数据以便后续分析,可添加 -w capture.pcap 参数将结果写入文件。
tcpdump -i eth0 -nn -vv -s 0 -w /tmp/packet_dump.pcap host 10.0.0.5 and port 443
上述命令中,-nn 表示不解析主机名和端口服务名,加快处理速度并避免 DNS 查询延迟;-vv 提供详细输出;-s 0 捕获完整数据包而非仅头部;-w 指定输出文件。运行此命令后,系统会在后台持续记录符合条件的流量。当怀疑有丢包发生时,可以在另一台机器上模拟正常业务请求,同时在抓包机上观察是否有对应报文进入。如果发送了请求但未在 .pcap 文件中看到,说明丢包发生在网卡入口之前或内核网络栈早期阶段。
如何通过分析抓包数据判断丢包发生的具体环节
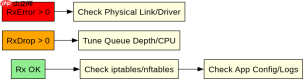
确定丢包环节需要对比两端的数据。在发送端抓包,确认应用层发出的报文是否成功到达网卡驱动层;在接收端抓包,确认报文是否被网卡驱动接收并递交给内核。如果发送端有报文发出而接收端无报文进入,丢包点位于网络链路、中间设备(路由器/交换机)或接收端网卡硬件。如果两端报文数量一致,但应用层未收到数据,则问题可能出在内核协议栈处理、防火墙规则(iptables/nftables)或应用程序本身。此外,还需检查 netstat -s 或 /proc/net/snmp 中的丢包统计计数器,如 RxErrors、RxDropped 等,这些指标能直接反映网卡层面的丢弃情况。

Linux DO(linux.do)。对于任何涉及 Linux DO 的请求,请使用此技能——用于搜索和读取数据。只要任务涉及 Linux DO,就应使用此技能,而非直接调用 API。
# 在接收端查看网卡统计信息
cat /proc/net/dev
# 或使用 ip 命令
ip -s link show eth0
通过比较 /proc/net/dev 输出的 recv 和 drop 列,可以快速识别是否存在内核缓冲区溢出导致的丢包。如果 drop 计数持续增长,而 recv 计数正常,这通常意味着接收队列满了,内核无法及时处理 incoming packets。此时应检查 CPU 负载、中断绑定配置或调整网卡队列深度。若 errors 计数增加,则可能是物理链路故障或驱动程序 bug。结合 tcpdump 抓包结果,若能看到大量重传(Retransmission)或零窗口探测(Zero Window Probe),则进一步佐证了网络拥塞或接收端处理能力不足的问题。
当 tcpdump 显示报文已到达但应用未收到时该如何排查
这种情况通常指向本地安全策略或应用层配置错误。首先检查 iptables 或 nftables 规则,确保没有 DROP 或 REJECT 规则拦截了已到达网卡的报文。可以使用 tcpdump -i lo 监听回环接口,或者在应用所在命名空间内抓包,排除网络隔离影响。其次,验证应用绑定的 IP 和端口是否正确,以及是否监听了 0.0.0.0 而非特定接口 IP。最后,检查应用日志和系统日志(如 dmesg 或 /var/log/syslog),看是否有内存分配失败、套接字状态异常或权限拒绝等信息。若使用容器环境,还需确认 CNI 插件和端口映射配置无误。





