






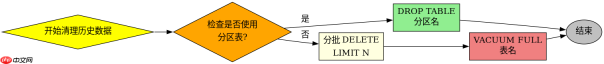
在postgresql 15中,从大表中快速清理历史数据的最有效方法是使用 drop table 配合分区表(partitioning),或者对非分区表使用 delete 结合 vacuum full。对于拥有数十亿行且按时间范围分区的表,直接删除整个分区(即 drop table)是瞬间完成的,因为它只涉及元数据操作,不产生大量的wal日志和锁竞争。如果表未分区,则应使用带有 limit 的批量 delete 语句,以避免事务膨胀和锁超时,随后执行 vacuum full 以回收磁盘空间。
如何设计支持快速删除的分区策略?
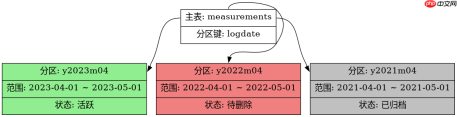
要实现秒级删除,核心在于将数据按时间范围进行物理隔离。在PostgreSQL 15中,推荐使用声明式分区(Declarative Partitioning)。通过将主表定义为范围分区,并按 created_at 字段划分区间,旧的数据会被存储在独立的子表中。当需要清理一年前的数据时,只需找到对应的分区并执行 DROP TABLE。这种方法避免了全表扫描和逐行删除的性能开销,同时保持了主表的索引效率。
CREATE TABLE measurements (
    city_id         int not null,
    logdate         date not null,
    peaktemp        int,
    unitsales       int
) PARTITION BY RANGE (logdate);

-- 创建当前分区
CREATE TABLE measurements_y2023m04 PARTITION OF measurements
    FOR VALUES FROM ('2023-04-01') TO ('2023-05-01');

-- 创建历史分区
CREATE TABLE measurements_y2022m04 PARTITION OF measurements
    FOR VALUES FROM ('2022-04-01') TO ('2022-05-01');

-- 模拟插入数据
INSERT INTO measurements SELECT random()::int, '2022-04-01'::date + i, random()::int, random()::int
FROM generate_series(1, 1000000) AS s(i); -- 假设插入了大量数据

-- 快速清理:直接删除整个分区
DROP TABLE IF EXISTS measurements_y2022m04;
上述代码展示了如何创建一个按日期范围分区的表。首先定义主表结构并指定分区键。接着,为不同的月份创建具体的分区。在实际操作中,你可以编写一个脚本定期创建未来的分区,并删除过期的分区。当执行 DROP TABLE measurements_y2022m04 时,PostgreSQL 会立即释放该分区占用的所有磁盘块,无需等待垃圾回收机制。
非分区表的大规模数据删除方案是什么?
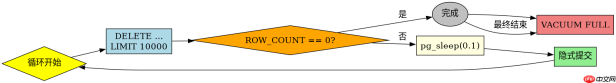
如果由于架构限制无法使用分区表,必须处理单一的大表,那么直接使用 DELETE FROM table WHERE condition 可能会导致严重的性能问题,包括长事务、锁持有时间过长以及事务日志(WAL)爆满。推荐的替代方案是采用“分批删除”策略。通过在一个循环中使用 DELETE ... LIMIT n,每次只删除少量数据并提交事务。这样可以减少单次事务的负载,允许其他查询并发执行。删除完成后,必须运行 VACUUM FULL 来真正回收空间,因为普通的 VACUUM 只是标记空间为可用,不会缩小表文件。
LIMIT 10000


