






postgresql 15 中利用 filter 子句实现条件聚合,核心做法是在聚合函数后直接附加 filter (where ...) 语法,从而在单次扫描中完成多组条件的统计。这种方式避免了使用 case when 或多次自连接带来的性能损耗,能够高效地生成如“按状态分组并分别统计总数和特定状态数量”的结果集。

FILTER 与 CASE WHEN 的执行效率对比
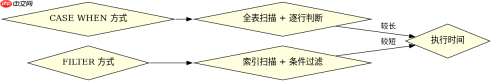
在处理复杂条件时,传统的 CASE WHEN 写法会导致全表扫描后对每一行进行逻辑判断,而 FILTER 子句允许数据库优化器更精准地识别过滤路径。通过对比两者生成的执行计划,可以直观看到 FILTER 在减少中间计算量上的优势。
SELECT
    status,
    COUNT(*) AS total_count,
    COUNT(*) FILTER (WHERE amount > 100) AS high_value_count
FROM orders
GROUP BY status;
预期结果:返回包含 status、total_count 和 high_value_count 的表格,其中 high_value_count 仅统计金额大于 100 的记录。
如何结合多个 FILTER 子句处理多维条件?
当需要同时统计多个互斥或重叠的条件时,可以在同一查询中并列使用多个 FILTER 子句。每个子句独立作用于对应的聚合函数,互不干扰,且共享相同的分组上下文。这种写法不仅代码简洁,而且能确保所有条件统计基于同一批数据源,避免数据不一致。
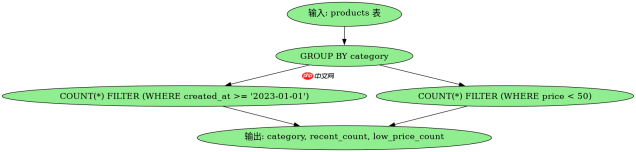
SELECT
    category,
    COUNT(*) FILTER (WHERE created_at >= '2023-01-01') AS recent_count,
    COUNT(*) FILTER (WHERE price <p>预期结果:返回包含 <code>category</code>、<code>recent_count</code> 和 <code>low_price_count</code> 的表格,分别反映不同条件下的产品数量。</p><h2>当 <code>FILTER</code> 条件为 NULL 时如何处理?</h2><p>在 PostgreSQL 中,<code>FILTER</code> 子句中的 <code>NULL</code> 值会被自动排除在聚合计数之外,因为 <code>COUNT(*)</code> 会统计所有行,但 <code>FILTER (WHERE condition)</code> 仅在条件为真时才计入。如果条件涉及 <code>NULL</code> 比较,需显式使用 <code>IS NULL</code> 或 <code>IS NOT NULL</code> 来明确意图,否则可能导致统计偏差。</p>


