






利用oracle的group by扩展语句(如grouping sets、cube或rollup)可以将原本需要多次扫描表并union all聚合的结果合并为单次扫描,从而显著减少i/o开销。具体做法是在select子句中使用grouping sets指定多组分组维度,数据库引擎会在一次执行计划中完成所有维度的聚合计算,避免了重复读取基表数据。
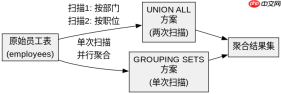
如何编写包含多个维度的GROUPING SETS查询
当需要同时统计按部门汇总和按职位汇总的数据时,可以使用GROUPING SETS语法将两个独立的GROUP BY查询合并。假设有一张员工表 employees,包含 department_id 和 job_id 字段,目标是分别获取每个部门的总薪资和每个职位的总薪资。通过定义 GROUPING SETS ((department_id), (job_id)),查询会返回两组结果:一组按部门分组,另一组按职位分组,且这两组结果在同一个结果集中呈现,未参与当前分组的维度值为NULL。
SELECT department_id, job_id, SUM(salary) AS total_salary
FROM employees
GROUP BY GROUPING SETS ((department_id), (job_id));
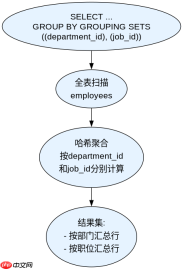
该查询的执行计划显示为单次全表扫描后直接进行哈希聚合,相比使用UNION ALL连接两个单独查询,减少了磁盘I/O和临时表空间的使用。注意,如果某个维度没有数据,对应的行仍会存在,只是聚合值为NULL或0,需根据业务需求处理空值。
如何处理扩展语句中的NULL值以区分不同维度
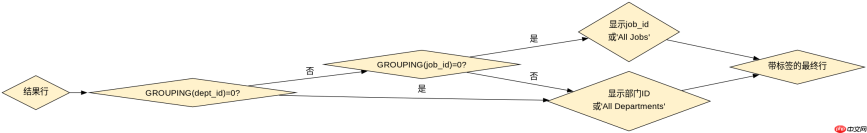
在GROUPING SETS的结果中,未参与当前分组的列会自动填充为NULL,这可能导致无法直观区分“无数据”和“特定维度缺失”。为了准确识别每一行属于哪个分组集合,应使用 GROUPING() 函数。该函数返回一个位掩码,若某列在当前分组中被忽略,则对应位为1,否则为0。结合 CASE 表达式或 DECODE 函数,可以生成清晰的分类标签,便于前端展示或后续逻辑判断。

SELECT
  CASE WHEN GROUPING(department_id) = 1 THEN 'All Departments' ELSE TO_CHAR(department_id) END AS dept_label,
  CASE WHEN GROUPING(job_id) = 1 THEN 'All Jobs' ELSE job_id END AS job_label,
  SUM(salary) AS total_salary
FROM employees
GROUP BY GROUPING SETS ((department_id), (job_id));
此写法确保每行结果都带有明确的语义标签,例如当 department_id 为NULL但 job_id 有值时,标签显示为具体职位;反之则显示为“All Departments”。这种处理方式不仅提升了可读性,也避免了因NULL值引发的歧义,特别适用于报表生成场景。
基于GROUPING()返回值的具体问题:如何判断某行是否属于特定分组集合
在实际应用中,开发者常需判断某一行结果是否来自特定的分组集合,例如仅筛选出按部门汇总的行。此时可直接检查 GROUPING(department_id) 的返回值:若为0,表示该行参与了 department_id 分组;若为1,则表示未参与。这一机制允许在不增加额外扫描的前提下,灵活过滤或标记不同维度的聚合结果,是优化复杂多维分析查询的关键技巧。


