






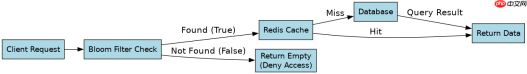
在go-zero框架中集成布隆过滤器防止缓存穿透,核心做法是在redis客户端初始化时加载预生成的布隆过滤器实例,并在业务逻辑层拦截查询请求。具体而言,需要引入
如何初始化并加载布隆过滤器到内存中
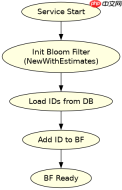
初始化阶段主要解决“数据从哪来”和“怎么存”的问题。通常的做法是创建一个固定大小的布隆过滤器对象,并将数据库中已存在的主键ID批量导入。这一步必须在服务启动初期完成,确保后续请求到来时过滤器已经就绪。
package main

import (
	"fmt"
	"log"

	"github.com/bits-and-blooms/bloom/v3"
)

func main() {
	// 假设我们预计有100万条数据,允许的错误率为0.01
	bf := bloom.NewWithEstimates(1000000, 0.01)

	// 模拟从数据库获取到的所有有效ID
	ids := []uint64{1001, 1002, 1003, 9999}

	for _, id := range ids {
		bf.AddStr(fmt.Sprintf("%d", id))
	}

	// 验证:存在的ID应返回true
	fmt.Println(bf.TestStr("1001")) // true
	// 验证:不存在的ID应返回false
	fmt.Println(bf.TestStr("8888")) // false
}
上述代码展示了最基础的内存型布隆过滤器构建过程。main函数或依赖注入阶段执行。需要注意的是,如果数据量极大,内存占用会显著增加,此时应考虑使用Redis的布隆过滤器功能而非纯内存方案。
如何在业务逻辑中拦截无效请求
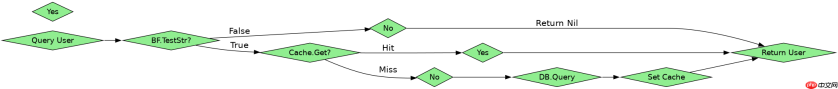
拦截逻辑的核心在于“先查过滤器,再查缓存”。在Go-Zero的服务实现中,我们需要在具体的Query方法入口处插入判断逻辑。只有当布隆过滤器确认该ID可能存在时,才继续执行后续的Redis查询和数据库回源操作。

type UserService struct {
	BloomFilter *bloom.BloomFilter
	Cache       cache.Cache
}

func (s *UserService) GetUser(id uint64) (*User, error) {
	key := fmt.Sprintf("user:%d", id)

	// 第一步:布隆过滤器拦截
	if !s.BloomFilter.TestStr(key) {
		// 绝对不存在,直接返回空,不查DB/Cache
		return nil, nil
	}

	// 第二步:查缓存
	var user User
	found, err := s.Cache.Get(s.ctx, key, &user)
	if err != nil || !found {
		// 第三步:查数据库并回填缓存
		user = s.queryDB(id)
		s.Cache.Set(s.ctx, key, &user, 30*time.Minute)
	}

	return &user, nil
}
在这个示例中,GetUser方法首先检查BloomFilter.TestStr的结果。如果结果为false,说明该用户ID根本不在数据库中,直接返回nil,彻底阻断了缓存穿透的路径。如果结果为true,则进入正常的缓存读取流程。这里必须强调,由于布隆过滤器存在极小概率的误判(即实际不存在但判定为存在),因此即使通过了过滤器,仍然需要处理缓存未命中的情况,即回源数据库的逻辑不能省略。
如何处理布隆过滤器更新与数据一致性
当新数据写入数据库时,必须同步更新布隆过滤器,否则会导致新数据被误判为不存在而拦截。在Go-Zero的微服务架构中,这通常通过事务或消息队列保证最终一致性。最简单的做法是在保存数据的同一事务中,将新ID加入内存过滤器或发送消息至Redis进行异步添加。
// 伪代码:在SaveUser方法中
func (s *UserService) SaveUser(user *User) error {
	// 1. 保存数据库
	err := s.db.Save(user)
	if err != nil {
		return err
	}

	// 2. 更新布隆过滤器
	key := fmt.Sprintf("user:%d", user.ID)
	s.BloomFilter.AddStr(key)

	return nil
}
对于高并发场景,直接操作内存过滤器可能成为瓶颈。此时建议将布隆过滤器托管给Redis,使用BF.ADD和BF.EXISTS命令。虽然增加了网络开销,但实现了状态共享和持久化。无论采用哪种方式,核心原则是:写操作必须先于或同时完成过滤器的更新,读操作始终优先校验过滤器。












