






在go-zero框架中接入elk实现分布式日志收集,核心做法是配置全局日志输出到标准输出(stdout),并配合filebeat等采集器将日志转发至elasticsearch。具体而言,需要在配置文件中使用log字段设置mode: "custom",并通过customwriter指定一个实现了io.writer接口的自定义结构体,该结构体负责将日志内容序列化后发送给logstash或fluentd。这样做的好处是日志格式统一且包含traceid,便于在kibana中进行链路追踪和聚合分析。

如何配置Go-Zero的日志模式以支持自定义输出
要实现自定义日志输出,必须在etc/xxx.yaml配置文件中修改log部分,将Mode设置为custom,并填入CustomWriter的配置项。Go-Zero内置的日志模块支持多种模式,如console、file和remote,但只有custom模式允许开发者注入自己的写入逻辑。通过这种方式,你可以控制日志的序列化格式,例如添加JSON包装或提取上下文信息,从而满足ELK栈对结构化数据的需求。
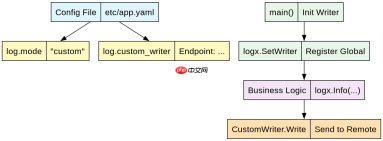
package main

import (
    "fmt"
    "io"
    "log"
    "net/http"
    "strings"

    "github.com/zeromicro/go-zero/core/logx"
)

// CustomLogWriter 实现 io.Writer 接口
type CustomLogWriter struct {
    endpoint string
}

func (c *CustomLogWriter) Write(p []byte) (n int, err error) {
    // 去除换行符并发送 HTTP POST 请求
    content := strings.TrimSpace(string(p))
    fmt.Printf("Sending to ELK: %s\n", content)
    // 实际项目中应使用 http.Client 发送 POST 请求到 Logstash/Fluentd
    return len(p), nil
}

func main() {
    // 初始化自定义 Writer
    writer := &CustomLogWriter{endpoint: "http://localhost:5044"}

    // 注册为全局日志写入器
    logx.SetWriter(writer)

    // 测试日志
    logx.Info("This is a test log message")
}
如何在代码中集成 TraceID 以实现链路追踪
在Go-Zero中集成TraceID的关键在于利用中间件和上下文传递机制。当请求进入时,网关或上游服务会生成一个唯一的TraceID,并将其放入HTTP Header中。你需要编写一个自定义中间件,从Header中提取TraceID,并将其存入Go-Zero的上下文中。随后,在自定义日志写入器中,通过读取上下文获取TraceID,并将其附加到每条日志记录中。这样,当日志被发送到ELK后,你可以通过TraceID在Kibana中串联起整个微服务链路的日志。


package middleware

import (
    "context"
    "net/http"
    "github.com/zeromicro/go-zero/core/logx"
    "github.com/google/uuid"
)

const traceIdKey = "traceId"

// TraceIdMiddleware 提取或生成 TraceID 并注入上下文
func TraceIdMiddleware(next http.Handler) http.Handler {
    return http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
        ctx := r.Context()
        traceId := r.Header.Get("X-Trace-Id")
        if traceId == "" {
            traceId = uuid.New().String()
        }
        ctx = context.WithValue(ctx, traceIdKey, traceId)
        next.ServeHTTP(w, r.WithContext(ctx))
    })
}

// GetTraceIdFromContext 辅助函数,用于在业务逻辑中获取 TraceID
func GetTraceIdFromContext(ctx context.Context) string {
    if tid, ok := ctx.Value(traceIdKey).(string); ok {
        return tid
    }
    return "unknown"
}
自定义日志写入器如何处理并发写入与性能瓶颈
在分布式系统中,高并发请求会导致大量日志同时产生,如果直接在Write方法中进行同步网络IO,极易造成阻塞和性能下降。因此,最佳实践是在自定义写入器内部维护一个缓冲通道(Buffered Channel)。当Write方法被调用时,仅将日志消息发送到通道后立即返回,由后台协程异步从通道中取出消息并执行网络发送。这种生产者-消费者模型能有效解耦日志记录与网络传输,提升系统吞吐量。此外,还需考虑通道满时的处理策略,例如丢弃旧日志或阻塞等待,以确保系统的稳定性。












