






nginx 默认使用加权轮询(weighted round robin)算法将请求分发到后端服务器。该算法会根据配置中每个 `server` 的权重值按比例分配请求,权重越高获取的请求越多;当后端服务器响应失败时,nginx 会自动将其剔除出可用列表,待恢复后重新加入,确保流量均匀且具备基本的容错能力。
如何配置不同权重的后端节点
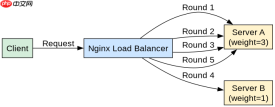
在 Nginx 的 `upstream` 模块中,可以通过 `weight` 参数为不同的后端服务器指定权重。权重默认为 1,数值越大,该服务器被选中的概率越高。例如,若 A 服务器权重为 3,B 服务器权重为 1,则每 4 个请求中会有 3 个发给 A,1 个发给 B。这种配置适用于后端机器性能不一致的场景,能最大化利用高性能服务器的处理能力。
upstream backend_pool {
    server 192.168.1.10:8080 weight=3;
    server 192.168.1.11:8080 weight=1;
}
上述配置定义了一个名为 backend_pool 的后端池。客户端请求进入时,Nginx 会维护一个全局的计数器或状态机,按照权重比例依次选择服务器。对于权重为 3 的 192.168.1.10,它会在连续三次调度中被选中,而权重为 1 的 192.168.1.11 则在第四次被选中,随后循环重复此模式。这种分布是确定性的,便于预测流量走向。
后端服务器宕机时的处理机制
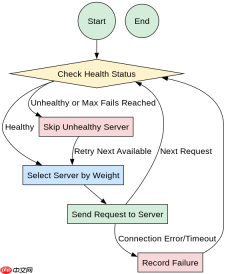
当某个后端服务器不可用时,Nginx 的轮询算法会自动跳过该节点,仅向健康的服务器分发请求。如果所有服务器都不可用,Nginx 会返回 502 Bad Gateway 错误。健康检查并非实时主动探测,而是基于被动式检测:只有当有实际请求发往故障节点并收到连接拒绝或超时等错误时,Nginx 才会标记该节点为不可用。在 max_fails 和 fail_timeout 参数的控制下,Nginx 会在指定时间内忽略对该节点的请求,直到超时结束后再次尝试访问以判断其是否恢复。

upstream backend_pool {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
}
在上述配置中,max_fails=3 表示允许的最大失败次数为 3 次,fail_timeout=30s 表示在 30 秒的时间窗口内累计失败达到 3 次后,将该服务器标记为不可用。在这 30 秒内,任何新请求都不会发送给该服务器。30 秒后,Nginx 会发送一个测试请求,如果成功,则恢复该服务器的正常调度;如果失败,则重置计时器并继续标记为不可用。这种机制避免了频繁的健康探测开销,同时保证了系统的稳定性。
基于特定输入条件的请求分发结果
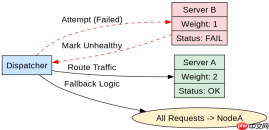
假设当前有两个后端服务器:server_A 权重为 2,server_B 权重为 1。在没有故障的情况下,前三个请求的分发顺序是固定的:server_A、server_A、server_B。第四个请求重新开始循环,再次指向 server_A。这种确定性分布意味着,如果客户端保持长连接或发送大量短连接,可以预期到特定的负载分布比例。若 server_B 在第 3 个请求时宕机,则第 4 个及之后的所有请求都将只由 server_A 处理,直到 server_B 恢复或被手动移除配置。





