






SQL存储过程重编译会瞬间打满服务器CPU
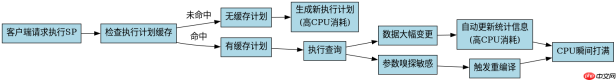
sql存储过程重编译瞬间打满服务器cpu,通常是因为发生了“递归重编译”或“并发重编译风暴”,导致大量线程同时执行昂贵的查询计划生成逻辑。要解决这个问题,需要定位具体的触发条件(如统计信息过期、参数嗅探失效),并通过强制使用特定计划、优化统计信息更新频率或调整数据库兼容性级别来抑制不必要的重编译行为。
如何排查并解决因参数嗅探导致的频繁重编译
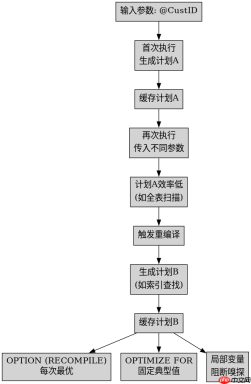
当存储过程首次执行时,SQL Server会根据传入的参数生成执行计划并缓存。如果后续传入的参数分布极不均匀(例如第一次查‘北京’返回10条,第二次查‘中国’返回10万条),SQL Server可能会认为原计划效率低下,从而触发重编译以寻找更优计划。这种频繁的自适应重编译会消耗大量CPU资源。解决方法是使用`OPTION (RECOMPILE)`强制每次重新编译以获得最佳参数化计划,或者使用`OPTIMIZE FOR`提示指定典型参数值,亦或是使用局部变量隔离参数嗅探。
CREATE PROCEDURE GetOrdersByCustomer
    @CustomerID INT
AS
BEGIN
    -- 方法1:使用 OPTIMIZE FOR 避免极端值干扰
    SELECT * FROM Orders
    WHERE CustomerID = @CustomerID
    OPTION (OPTIMIZE FOR (@CustomerID = 100));

    -- 方法2:使用局部变量阻断参数嗅探
    DECLARE @LocalID INT = @CustomerID;
    SELECT * FROM Orders
    WHERE CustomerID = @LocalID;
END;
如何诊断由统计信息自动更新引发的CPU飙升
SQL Server会在数据修改达到一定阈值时自动更新统计信息,这个过程本身就需要扫描表数据并占用CPU。如果表数据量巨大且并发写入频繁,自动统计信息更新会与业务查询竞争CPU资源,甚至引发锁等待和阻塞链。此外,过时的统计信息会导致执行计划选择错误(如全表扫描而非索引查找),进而引发大量的I/O和CPU计算。通过监控`sp_recompile`调用频率和统计信息更新时间戳,可以确认是否为统计信息问题。解决方案包括手动控制统计信息更新策略、使用增量统计信息(Incremental Statistics)或调整`AUTO_UPDATE_STATISTICS_ASYNC`设置。


-- 查看最近一次统计信息更新时间
SELECT
    t.name AS TableName,
    s.name AS StatName,
    s.last_updated,
    s.rows_sampled,
    s.rows
FROM sys.stats s
JOIN sys.tables t ON s.object_id = t.object_id
WHERE t.name = 'Orders'
ORDER BY s.last_updated DESC;
基于程序中某个输入、条件或结果的具体问题
在程序调用存储过程时,如果传入的`@CustomerID`参数值为NULL或未提供默认值,而存储过程内部未对NULL进行特殊处理,可能会导致执行计划无法重用或触发隐式转换,进而引发额外的CPU开销。具体表现为,当参数为NULL时,查询可能退化为全表扫描,并在每次执行时重新评估执行路径。通过在存储过程入口处显式检查NULL值并提供默认行为,可以有效避免此类非预期的重编译和资源消耗。





