






sql存储过程首次执行快、第二次变慢,通常是因为第一次执行触发了编译或缓存加载,而后续执行受参数嗅探(parameter sniffing)影响,使用了不合适的执行计划。具体做法是检查执行计划是否固定了错误的索引或扫描方式,并通过强制重新编译或使用局部变量来优化。

为什么首次执行会触发编译开销
首次执行时,数据库需要解析SQL文本、检查权限、生成查询树并选择最优执行计划,这个过程涉及大量的CPU计算和元数据查找。如果存储过程复杂,或者依赖的表统计信息过期,编译时间会更长。但通常“首次快”是指用户感知到的响应时间,实际上可能是由于冷启动时操作系统页面加载或数据库缓冲池预热导致的假象,或者更常见的是,第一次执行生成了一个针对特定参数的“好”计划,而后续执行因为参数变化导致计划失效或重新优化。
-- 创建测试存储过程
CREATE PROCEDURE GetUserData
    @UserId INT
AS
BEGIN
    SELECT * FROM Users WHERE Id = @UserId;
END;
预期结果:首次调用 EXEC GetUserData 1 会显示编译耗时,后续调用可能因参数嗅探使用不同计划。
参数嗅探如何导致第二次执行变慢
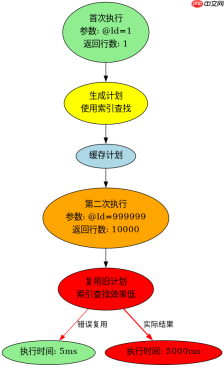
参数嗅探发生在存储过程第一次执行后,SQL Server 将生成的执行计划缓存起来。如果第一次执行的参数是特例(例如返回极少行数),缓存的计划可能使用索引查找。当第二次执行传入一个返回大量数据的参数时,数据库仍复用该计划,导致全表扫描或嵌套循环连接,从而显著变慢。这是最常见的原因。


-- 模拟参数嗅探问题
-- 第一次执行:@UserId = 1 (假设只有1行)
EXEC GetUserData 1;
-- 第二次执行:@UserId = 999999 (假设返回10000行)
EXEC GetUserData 999999;
预期结果:第二次执行时间远大于第一次,执行计划显示为表扫描而非索引查找。
如何通过局部变量避免参数嗅探
在存储过程内部使用局部变量接收输入参数,可以阻止数据库根据实际参数值生成执行计划,从而避免参数嗅探带来的性能波动。虽然这可能导致计划不够精确,但在参数分布不均的场景下,能提供更稳定的性能表现。
-- 优化后的存储过程
CREATE PROCEDURE GetUserDataOptimized
    @UserId INT
AS
BEGIN
    DECLARE @LocalUserId INT = @UserId;
    SELECT * FROM Users WHERE Id = @LocalUserId;
END;
预期结果:无论传入什么参数,执行计划保持一致,性能稳定但可能不是最优。





