






排查oracle rac私网bonding绑定失效的高可用隐患,核心在于确认操作系统层面的网络接口状态与rac集群软件(crs)的感知是否一致。具体做法是检查`ifenslave`或`/sys/class/net`下的成员关系,验证`crsctl stat res -t`中`ora.net1.network`等资源的`online`状态及绑定的ip地址,并审查`/var/log/messages`中关于网卡链路抖动或bonding模式切换的日志。若发现私网心跳中断但物理链路正常,通常是因为bonding驱动未正确接管故障转移,导致rac节点间通信超时从而触发实例驱逐。

如何验证Linux系统层Bonding配置是否正确生效
验证Bonding配置是否生效,需直接查询内核模块加载状态及虚拟接口的属性文件。通过`cat /proc/net/bonding/bondX`命令可以查看当前活动的Slave网卡、负载均衡算法以及主备状态。如果该文件不存在或内容为空,说明`bonding`模块未加载或配置未应用。同时,使用`ip link show bondX`检查接口状态是否为`UP`,并通过`ethtool bondX`确认聚合速率和双工模式是否与物理网卡匹配。只有当所有Slave网卡在`/proc/net/bonding/bondX`中均显示为`up`且Master接口处于`UP`状态时,系统层的绑定才被视为有效。
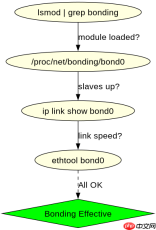
#!/bin/bash
# 检查Bonding状态脚本 check_bond.sh
BOND_IF="bond0"
SLAVE_IFS=("eth1" "eth2")

# 1. 检查bonding模块是否加载
if ! lsmod | grep -q bonding; then
    echo "ERROR: bonding module not loaded"
    exit 1
fi

# 2. 检查/proc/net/bonding是否存在
if [ ! -f /proc/net/bonding/$BOND_IF ]; then
    echo "ERROR: $BOND_IF bonding info not found in /proc"
    exit 1
fi

# 3. 解析Slave状态
ACTIVE_SLAVES=$(grep -c "Slave Interface.*up" /proc/net/bonding/$BOND_IF)
TOTAL_SLAVES=${#SLAVE_IFS[@]}

if [ "$ACTIVE_SLAVES" -eq "$TOTAL_SLAVES" ]; then
    echo "SUCCESS: All $TOTAL_SLAVES slaves are up on $BOND_IF"
else
    echo "WARNING: Only $ACTIVE_SLAVES of $TOTAL_SLAVES slaves are up"
    cat /proc/net/bonding/$BOND_IF
fi

# 4. 检查RAC网络资源关联
ocrcheck || crsctl stat res -t | grep -i network
运行上述脚本后,预期输出应显示所有配置的Slave网卡状态均为`up`。若某张物理网卡显示为`down`,则需进一步检查该网卡的物理连接及驱动状态。同时,`ocrcheck`用于确认OCR磁盘组可访问性,而`crsctl stat res`的输出中,`ora.net1.network`等资源必须显示为`ONLINE`,且其`TARGET`状态为`ONLINE`。如果网络资源显示为`OFFLINE`或`STARTING`,则表明RAC未能通过Bonding接口建立心跳,此时需结合日志分析原因。
如何定位RAC集群因私网心跳丢失导致的节点驱逐
定位RAC集群因私网心跳丢失导致的节点驱逐,关键在于分析`alert.log`和`evmd.log`中的时间戳对齐信息。当Bonding失效导致心跳包发送失败时,Evma进程会记录`Network interface down`或`Heartbeat timeout`错误。随后,CSS进程会检测到其他节点的响应超时,并在`cssd.log`中生成`Disk timeout`或`Network timeout`事件。最终,OCD进程会根据表决盘的状态决定驱逐节点。排查时需对比各节点`alert.log`中`PMON`进程报错的时间点,若多个节点在同一时间段内出现私网通信中断,且伴随`ORA-29701`或`ORA-29702`错误,则可确认为私网Bonding问题引发的集群分裂。


-- SQL*Plus 会话示例:检查集群节点状态及网络资源
-- 以grid用户执行

-- 1. 检查集群整体状态
$ crsctl check cluster -all

-- 2. 详细查看所有资源状态,重点关注网络资源
$ crsctl stat res -t -init

-- 3. 检查特定网络资源的属性
$ crsctl stat res ora.net1.network -p | grep -E "(NETWORK|IFNAME|TYPE)"

-- 4. 查看最近一次的节点驱逐记录(需root用户)
$ tail -n 100 /var/log/crsd/crsd.log | grep -i "evict\|timeout\|network"

-- 5. 检查OS层面网卡统计丢包情况
$ ethtool -S eth1 | grep drop
$ ethtool -S eth2 | grep drop
在执行上述命令后,预期结果应显示所有节点状态为`ONLINE`,且`ora.net1.network`的资源状态为`ONLINE`。若`crsctl stat res -t`显示某个节点上的网络资源为`OFFLINE`,则需检查该节点上的`ifcfg-bond0`配置文件是否正确指向了物理网卡。同时,`ethtool -S`输出的丢包计数若持续增加,表明物理链路存在质量问题,即使Bonding逻辑上存活,实际数据传输也会失败。通过对比`crsd.log`中的驱逐时间与`ethtool`的丢包激增时间点,可以精确锁定故障根源是配置错误还是硬件故障。
基于Bonding模式为active-backup时的故障切换测试
基于Bonding模式为`active-backup`时的故障切换测试,旨在验证当主用物理网卡断开时,备用网卡能否无缝接管心跳流量。具体做法是在一个节点上手动禁用主用Slave网卡(如`ifconfig eth1 down`),然后立即观察RAC集群状态及另一节点的心跳响应。若切换成功,`crsctl stat res -t`应保持所有资源`ONLINE`,且`ping`私网IP的延迟不应有显著波动。若切换失败,集群可能记录`Network unreachable`错误,甚至触发节点驱逐。此测试需在维护窗口进行,并确保有回退方案,因为频繁的链路抖动可能导致集群不稳定。
# 故障切换测试脚本 test_failover.sh
NODE_A="rac1.example.com"
NODE_B="rac2.example.com"
BOND_IF="bond0"
PRIMARY_SLAVE="eth1"
SECONDARY_SLAVE="eth2"

# 在Node A上执行
ssh $NODE_A "ifconfig $PRIMARY_SLAVE down"

# 等待几秒让Bonding机制切换
sleep 5

# 检查Node A上的Bonding状态
ssh $NODE_A "cat /proc/net/bonding/$BOND_IF | grep 'Slave Interface'"

# 从Node B ping Node A的私网IP,检查连通性
PING_RESULT=$(ping -c 5 $(hostname -I | grep -oP '(?
<p>测试完成后,预期结果应为Node A的`/proc/net/bonding/bond0`显示`Secondary Slave`变为活动状态,且Node B到Node A的Ping测试成功率保持100%。若Ping测试出现丢包或超时,说明Bonding的故障切换机制未正常工作,可能是由于ARP监控配置错误或交换机端口配置不匹配。此时需检查`/etc/modprobe.d/bonding.conf`中的参数设置,确保`miimon`或`arp_interval`值合理,以便快速检测链路故障。恢复网卡后,需再次验证主备角色是否按预期切换回来,确保集群长期运行的稳定性。</p>


