






在 javascript 项目中,性能分析工具的选择取决于具体的优化目标:排查运行时 cpu 瓶颈首选 chrome devtools performance 面板,定位内存泄漏使用 memory 面板,而监控生产环境下的真实用户性能则依赖 web vitals 指标。对于 node.js 后端服务,应使用 `--prof` 生成 v8 日志配合 `flamegraph` 进行火焰图分析,或使用 clinic.js 套件进行异步 i/o 和堆内存诊断。
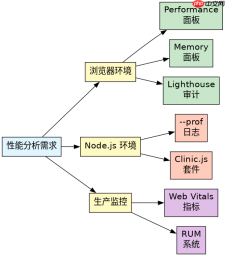
前端浏览器端性能分析工具对比
Chrome DevTools 是前端开发中最核心的性能分析平台,其 Performance 面板通过录制时间轴数据,能够精确展示主线程阻塞、长任务以及渲染帧率波动。Memory 面板则提供 Heap Snapshot 和 Allocation Timeline 两种模式,前者用于对比不同时刻的堆对象差异以定位内存泄漏,后者用于追踪对象分配过程。此外,Lighthouse 提供自动化的审计功能,涵盖性能、可访问性和 SEO 等多个维度,适合快速评估页面整体健康度。
const btn = document.getElementById('analyze');
btn.addEventListener('click', () => {
  // 启动 Performance 录制
  performance.mark('start-analysis');

  // 模拟耗时操作
  for (let i = 0; i <h2>Node.js 服务端性能诊断方案</h2><p>Node.js 的性能分析与浏览器环境不同,主要关注事件循环延迟、非阻塞 I/O 效率以及堆内存增长。V8 引擎内置的 `--prof` 标志可以生成详细的 C++ 调用栈日志,通过 `process-heap` 或 `flamegraph` 工具将其转换为可视化的火焰图,从而识别热点函数。Clinic.js 提供了更高级的诊断工具,如 Clinic Doctor 用于分析异步 I/O 瓶颈,Clinic Flame 用于生成火焰图,Clinic Bubbleprof 用于可视化事件循环活动。这些工具特别适合微服务架构中定位慢查询和资源竞争问题。</p><div class="aritcle_card flexRow artxards">
											<div class="artcardd flexRow">
												<a class="aritcle_card_img" rel="nofollow" href="/xiazai/skill13407" title="Java基础版"><img
														src="https://img.php.cn/upload/skill/001/246/273/6adaf20d79f23518.jpg" alt="Java基础版" onerror="this.onerror='';this.src='/static/lhimages/moren/morentu.png'" ></a>
												<div class="aritcle_card_info flexColumn">
													<a rel="nofollow" href="/xiazai/skill13407" title="Java基础版" class="overflowclass">Java基础版</a>
													<p class="overflowclass">编写健壮 Java 代码的基础能力,覆盖空指针防护、相等性判断与基础异常处理。</p>
												</div>
												<a rel="nofollow" href="/xiazai/skill13407" title="Java基础版" class="aritcle_card_btn flexRow flexcenter"><b></b><span>下载</span>
												</a>
											</div>
										</div><p><img src="https://img.php.cn/upload/article/001/242/473/179507107194967.png?x-oss-process=image/resize,p_40" alt="JavaScript 中性能分析工具对比怎么选"></p><pre class="brush:php;toolbar:false;">// 使用 --prof 运行脚本
// node --prof app.js

const http = require('http');
const server = http.createServer((req, res) => {
  // 模拟 CPU 密集型任务
  let sum = 0;
  for (let i = 0; i  {
  console.log('Server running on port 3000');
});
基于特定输入条件的性能表现差异
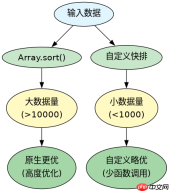
当处理大规模数组排序时,不同的算法实现会导致显著的性能差异。例如,使用原生 `Array.prototype.sort()` 与自定义的快速排序实现相比,在数据量较大且分布均匀的情况下,原生方法通常经过高度优化,性能更优。然而,在数据量较小或已部分有序的情况下,自定义实现可能因减少函数调用开销而表现更好。通过具体测试可以发现,当输入数组长度超过 10000 时,原生方法的稳定性优势更加明显,而在极端情况下(如大量重复元素),某些自定义实现可能会触发最坏情况,导致性能急剧下降。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南






