






Java 字节流与字符流中 流性能测试怎么做
通过对比读写相同大小文件时的耗时来评估性能,核心做法是分别使用 fileinputstream/fileoutputstream 和 filereader/filewriter 进行基准测试。为了准确反映真实场景,必须开启缓冲机制(如 bufferedinputstream),否则频繁的系统调用会导致性能差异失真。通常结论是:对于纯文本数据,字符流因涉及编码转换开销略慢于字节流;但对于二进制数据,字符流不适用,而字节流表现稳定。
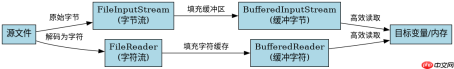
如何设计无缓冲的基准测试代码
直接实例化底层流对象并循环读取固定大小的缓冲区,可以测出最基础的 I/O 系统调用开销。这种写法能直观展示未优化时的性能瓶颈,即每次读取都触发一次内核态切换。
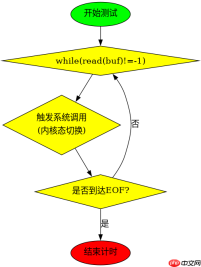
import java.io.*;

public class UnbufferedTest {
    public static void main(String[] args) throws Exception {
        String src = "test_unbuf.txt";
        // 准备测试文件
        try (FileOutputStream fos = new FileOutputStream(src)) {
            byte[] data = new byte[1024 * 1024]; // 1MB
            fos.write(data);
        }

        long start, end;

        // 测试字节流
        start = System.nanoTime();
        try (FileInputStream fis = new FileInputStream(src)) {
            byte[] buf = new byte[8192];
            while (fis.read(buf) != -1) {}
        }
        end = System.nanoTime();
        System.out.println("Unbuffered Byte: " + (end - start) / 1_000_000.0 + " ms");

        // 测试字符流
        start = System.nanoTime();
        try (FileReader fr = new FileReader(src)) {
            char[] buf = new char[8192];
            while (fr.read(buf) != -1) {}
        }
        end = System.nanoTime();
        System.out.println("Unbuffered Char: " + (end - start) / 1_000_000.0 + " ms");
    }
}
运行上述代码,你会看到两个数值。由于没有缓冲,两者都极慢,但字符流因为内部调用了 InputStreamReader 的默认解码逻辑,通常比字节流更慢一些。这证明了在高性能场景下,缓冲是必须的。
如何设计带缓冲的高性能测试代码
将底层流包裹在 BufferedInputStream 或 BufferedReader 中,利用内存中的数组减少磁盘交互次数。这是生产环境的标准用法,也是性能测试的重点对比对象。

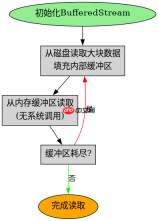
import java.io.*;

public class BufferedTest {
    public static void main(String[] args) throws Exception {
        String src = "test_buf.txt";
        // 准备测试文件
        try (FileOutputStream fos = new FileOutputStream(src)) {
            byte[] data = new byte[10 * 1024 * 1024]; // 10MB
            fos.write(data);
        }

        long start, end;

        // 测试缓冲字节流
        start = System.nanoTime();
        try (BufferedInputStream bis = new BufferedInputStream(new FileInputStream(src))) {
            byte[] buf = new byte[8192];
            while (bis.read(buf) != -1) {}
        }
        end = System.nanoTime();
        System.out.println("Buffered Byte: " + (end - start) / 1_000_000.0 + " ms");

        // 测试缓冲字符流
        start = System.nanoTime();
        try (BufferedReader br = new BufferedReader(new FileReader(src))) {
            char[] buf = new char[8192];
            while (br.read(buf) != -1) {}
        }
        end = System.nanoTime();
        System.out.println("Buffered Char: " + (end - start) / 1_000_000.0 + " ms");
    }
}
执行该程序,缓冲字节流的速度会显著提升,接近磁盘极限。缓冲字符流虽然也提升了,但由于多了一层 UTF-8 编解码计算,耗时仍会略高于字节流。如果处理的是非文本二进制数据,字符流甚至无法正确工作,因此字节流在通用性和极致速度上更具优势。
不同缓冲区大小对性能的具体影响是什么
缓冲区的大小直接决定了内存拷贝的次数与系统调用的频率。增大缓冲区可以减少 read() 的系统调用次数,但过大的缓冲区会增加 JVM 堆内存的压力和 GC 风险。通常 8KB 到 64KB 是最佳区间。当缓冲区小于操作系统页大小时,性能较差;当缓冲区大于磁盘扇区读取优化阈值时,收益递减。
Java免费学习笔记:立即使用
解锁 Java 大师之旅:从入门到精通的终极指南



